Unità 2: Regressione, Classificazione e Valutazione
Dopo aver visto come organizzare e suddividere i dati, in questa seconda unità vedremo come addestrare i nostri primi modelli predittivi usando la libreria Scikit-Learn. Affronteremo i due compiti principali dell’apprendimento supervisionato: la regressione e la classificazione.
2.1 Regressione Lineare (Prevedere valori continui)
Il modello più semplice e intuitivo per fare regressione è la Regressione Lineare. L’obiettivo è trovare una relazione lineare (una linea retta) che leghi la feature indipendente al target continuo .
L’equazione matematica di una retta con una sola feature è:
Dove:
- (in matematica chiamato coefficiente angolare ) rappresenta il peso (weight) assegnato alla feature. Determina la pendenza della retta.
- (in matematica chiamato intercetta ) rappresenta il bias (o termine noto). È il valore di quando .
La Funzione di Costo: Mean Squared Error (MSE)
Come fa l’algoritmo a capire qual è la “retta migliore”? Cerca di minimizzare l’errore commesso. Per misurare questo errore, si calcola l’Errore Quadratico Medio (Mean Squared Error - MSE):
Dove:
- è il numero totale di campioni nel dataset.
- è il valore reale (il target effettivo del campione ).
- (letto y-hat) è il valore previsto dal modello per il campione ().
- La differenza è il residuo (l’errore individuale). Elevandolo al quadrato, si evitano compensazioni tra errori positivi e negativi e si penalizzano maggiormente gli errori più grandi.
Come Trovare la Retta Migliore: Calcolo Diretto vs Addestramento Iterativo
Per trovare i valori ideali di e che rendono l’MSE il più piccolo possibile, esistono due strade principali:
-
Metodo Analitico (Calcolo Diretto): Esiste una formula matematica diretta (chiamata metodo dei Minimi Quadrati Ordinari o Equazione Normale) che consente di calcolare all’istante i valori esatti di e in un solo passaggio. È molto efficiente per dataset piccoli, ma diventa impraticabile se abbiamo milioni di caratteristiche (feature) perché richiede calcoli matriciali estremamente pesanti per i computer.
-
Metodo Iterativo (Discesa del Gradiente): Invece di calcolare la soluzione in un colpo solo, l’algoritmo effettua una serie di tentativi ripetuti (iterazioni):
- Inizializzazione: Si parte assegnando a e dei valori casuali (la retta iniziale sarà probabilmente pessima).
- Predizione ed Errore: Si calcola l’MSE con i parametri attuali.
- Aggiornamento (Passo di Addestramento): Si calcola la direzione in cui l’errore aumenta o diminuisce (il Gradiente) e si modificano leggermente e nella direzione che riduce l’errore.
- Ripetizione: Si ripete questo ciclo per centinaia o migliaia di volte (ogni ripetizione è un’iterazione o epoca) finché l’errore non scende al minimo e si stabilizza (fase di convergenza).
Nota (Perché è importante capire il concetto di Iterazione?): Mentre per la regressione lineare il calcolo diretto è tecnicamente possibile, per quasi tutti gli altri modelli di Machine Learning più complessi (come la regressione logistica e le reti neurali) non esiste una formula diretta per calcolare i parametri ottimali. L’unico modo per addestrarli è utilizzare un processo iterativo basato su tentativi e aggiustamenti successivi.
(Nota: Nei paragrafi successivi di questa stessa unità vedremo in dettaglio come la Discesa del Gradiente minimizza l’errore epoca dopo epoca, mentre nell’Unità 3 approfondiremo come si aggiornano i pesi nel Percettore).
📊 Un Esempio Pratico di Calcolo (Passo dopo Passo)
Per fissare bene le idee, facciamo un esempio numerico completo basato su un caso reale. Vogliamo prevedere il voto finale di uno studente basandoci sulle sue ore di studio settimanali. Immaginiamo di avere un piccolissimo dataset di 3 studenti:
- Studente 1: Studia ore Voto reale
- Studente 2: Studia ore Voto reale
- Studente 3: Studia ore Voto reale
Supponiamo che il nostro modello lineare sia già stato addestrato e abbia trovato la seguente retta ottimale:
Dove il peso (coefficiente angolare) è e il bias (intercetta) è .
1. Effettuare una Previsione per un Nuovo Studente
Se arriva un nuovo studente che ha studiato per 5 ore (), quale voto prevede il modello? Applichiamo l’equazione della retta:
Il modello prevede che lo studente otterrà un voto pari a 6.0.
2. Calcolo dell’Errore Quadratico Medio (MSE) sul Dataset
Per capire quanto è accurata la nostra retta su tutto il dataset, calcoliamo l’MSE. Calcoliamo la previsione e l’errore per ciascun studente:
- Studente 1 ():
- Previsione:
- Errore (Residuo):
- Errore Quadrato:
- Studente 2 ():
- Previsione:
- Errore (Residuo):
- Errore Quadrato:
- Studente 3 ():
- Previsione:
- Errore (Residuo):
- Errore Quadrato:
Infine, facciamo la media degli errori quadratici ():
Questo valore rappresenta l’errore totale (o costo) della nostra retta. Ma è un buon risultato? Come facciamo a capirlo?
- Il problema dell’unità di misura: Poiché i voti reali sono espressi in “punti” (es. 6.0 o 8.5), l’MSE si trova espresso in “punti al quadrato” (). Questo rende difficile valutarlo a colpo d’occhio.
- La soluzione (RMSE): Per riportare l’errore all’unità di misura originale (i voti), possiamo calcolare la radice quadrata dell’MSE (ottenendo la metrica chiamata RMSE - Root Mean Squared Error):
- La valutazione: Un errore medio di soli punti su una scala di voti scolastici da 1 a 10 significa che il modello è estremamente preciso! Le sue previsioni mancano il voto reale di pochissimo (meno di un terzo di voto).
Nota Importante (La Lezione più Importante per un Data Scientist): Un numero di per sé non significa nulla. Un errore di metri ( centimetri) è del tutto trascurabile se stiamo stimando la distanza geografica tra due città, ma sarebbe catastrofico in campo medico se un modello dovesse individuare la posizione di un tumore all’interno del corpo umano per orientare un fascio di radioterapia. In quel contesto, un errore di 29 centimetri colpirebbe un organo o tessuto sano completamente diverso, con conseguenze fatali! Sta sempre all’essere umano (al programmatore, al ricercatore) interpretare i dati conoscendo a fondo sia il funzionamento matematico degli strumenti, sia il contesto reale dell’applicazione. Non bisogna mai accettare ciecamente i risultati di un algoritmo senza aver compreso gli strumenti e il dominio in cui si sta operando.
(Nota didattica: in questo esempio abbiamo usato pesi e bias già calcolati per fare le nostre previsioni. Il processo matematico che permette all’algoritmo di partire da valori casuali ed effettuare le correzioni iterativamente per trovarli da solo verrà approfondito nell’Unità 3 - Addestramento e Valutazione).
Il Coefficiente di Determinazione ()
Mentre l’MSE (o l’RMSE) esprime l’errore nell’unità di misura dei dati (ad esempio, voti), esiste un’altra metrica fondamentale e universale per misurare la bontà di un modello di regressione: il coefficiente di determinazione, indicato come (R-quadrato).
Cos’è e come si interpreta?
L’ indica la proporzione di variabilità dei dati che il modello riesce a spiegare. Risponde alla domanda: quanto è migliore la mia retta di regressione rispetto a una stima “pigra” basata semplicemente sulla media di tutti i voti?
Il valore di varia generalmente tra e :
- : Il modello è perfetto. Spiega il 100% della variabilità dei dati e le sue previsioni sono del tutto prive di errore (tutti i punti reali si trovano esattamente sulla retta).
- : Il modello non è migliore del tirare a indovinare usando la media. Non spiega alcuna relazione tra le ore di studio e il voto finale.
- Valori intermedi (es. ): Significa che il modello spiega l’85% della variabilità dei dati reali, mentre il restante 15% è dovuto a rumore casuale o ad altri fattori non considerati dal modello (ad esempio, la difficoltà dell’esame o lo stato emotivo dello studente).
- Valori negativi: Sì, in rari casi l’ può essere negativo se la retta predice peggio rispetto al semplice calcolo della media storica.
La formula matematica e il suo significato
L’ mette a confronto l’errore del nostro modello con l’errore di un modello “linea di base” (baseline) che prevede sempre e solo la media dei valori reali ():
Per capire cosa significa questa frazione, analizziamo i due elementi:
-
Il Numeratore: (Residual Sum of Squares / Somma dei Quadrati dei Residui)
È la somma degli errori al quadrato commessi dalla nostra retta di regressione (la distanza tra il valore reale e quello previsto ). Rappresenta la quota di errore che il nostro modello non è riuscito a eliminare.
-
Il Denominatore: (Total Sum of Squares / Somma Totale dei Quadrati)
È la somma degli errori al quadrato che commetteremmo usando un “modello pigro”, che prevede per tutti i dati semplicemente il valore medio reale (), ignorando qualsiasi altra caratteristica (feature).
Esempio pratico: Immagina di dover indovinare il voto d’esame di uno studente a scatola chiusa, senza sapere quante ore ha studiato. La stima migliore (e più sicura) che puoi fare è usare la media dei voti dell’intera classe (). L’errore totale al quadrato di questa stima “alla cieca” è esattamente la .
-
La Frazione : Rappresenta la percentuale di errore che ancora rimane dopo aver usato la nostra retta di regressione. Ad esempio, se questa frazione vale , significa che il nostro modello lascia ancora inspiegato il della variabilità totale.
-
La Sottrazione : Sottraendo questa quota dal 100% (), otteniamo la percentuale di variabilità che il nostro modello è riuscito a spiegare e rimuovere. Se l’errore residuo è il , allora , ovvero il modello spiega l’ della variabilità dei dati.
Perché è utile?
A differenza dell’MSE e dell’RMSE, che cambiano a seconda della scala (un RMSE di è enorme se prevediamo voti scolastici, ma irrilevante se prevediamo prezzi di case), l’ è un numero puro (adimensionale).
Questo offre due importanti risvolti pratici da tenere a mente:
-
Indipendenza dalla scala e dal contesto di misura: Puoi comprendere all’istante la qualità matematica del modello senza conoscere l’unità di misura o l’ordine di grandezza dei dati. Un valore di indica sempre e comunque che il modello spiega il della variabilità, sia che si parli di millimetri, temperature o euro. Ciò permette di confrontare direttamente modelli addestrati su problemi e scale del tutto differenti.
-
La necessità di un’interpretazione basata sul dominio (contesto): Sebbene il numero sia matematicamente puro, la sua valutazione qualitativa dipende fortemente dal settore di applicazione:
-
Scienze esatte (es. fisica o ingegneria): i fenomeni seguono leggi naturali precise e il rumore di fondo è minimo. Ci si aspetta quindi un estremamente vicino a (es. o ). Un valore inferiore indica solitamente un modello inadeguato o problemi nei sensori.
-
Scienze sociali, economiche o mediche (es. comportamento umano o mercati finanziari): per via dell’elevata complessità intrinseca e delle innumerevoli variabili nascoste o non osservabili, ottenere un anche solo di o ( di varianza spiegata) può essere considerato un successo straordinario e un risultato scientificamente rilevante.
Nota Bene (Differenza tra e Accuratezza): Per uno studente alle prime armi, un valore di potrebbe far pensare erroneamente che il modello “sbagli il delle volte”. Questo è un grave errore concettuale. Nella regressione non esiste il concetto di “azzeccato/sbagliato” tipico dei problemi di classificazione (che misuriamo invece tramite la metrica di Accuratezza spiegata in fondo a questa unità). Un significa semplicemente che siamo riusciti a spiegare e ridurre del l’incertezza totale (la variabilità) legata a quel fenomeno grazie alle feature a nostra disposizione. Il restante è dovuto a fattori esterni che non abbiamo misurato (es. lo stato emotivo dello studente, la difficoltà specifica di una domanda) o a rumore casuale. Riuscire a spiegare il dell’incertezza su fenomeni complessi legati all’uomo o all’economia è spesso un risultato di enorme valore pratico.
-
2.2 Classificazione con la Regressione Logistica
Sebbene contenga il termine “regressione” nel nome, la Regressione Logistica è un algoritmo utilizzato per problemi di classificazione binaria (prevedere se un dato appartiene alla classe o alla classe ).
Se usassimo la regressione lineare direttamente per la classificazione, potremmo ottenere valori di previsione esterni all’intervallo (ad esempio o ), che non hanno senso se interpretati come probabilità.
Per risolvere questo problema, la regressione logistica utilizza una formula lineare interna (chiamata ):
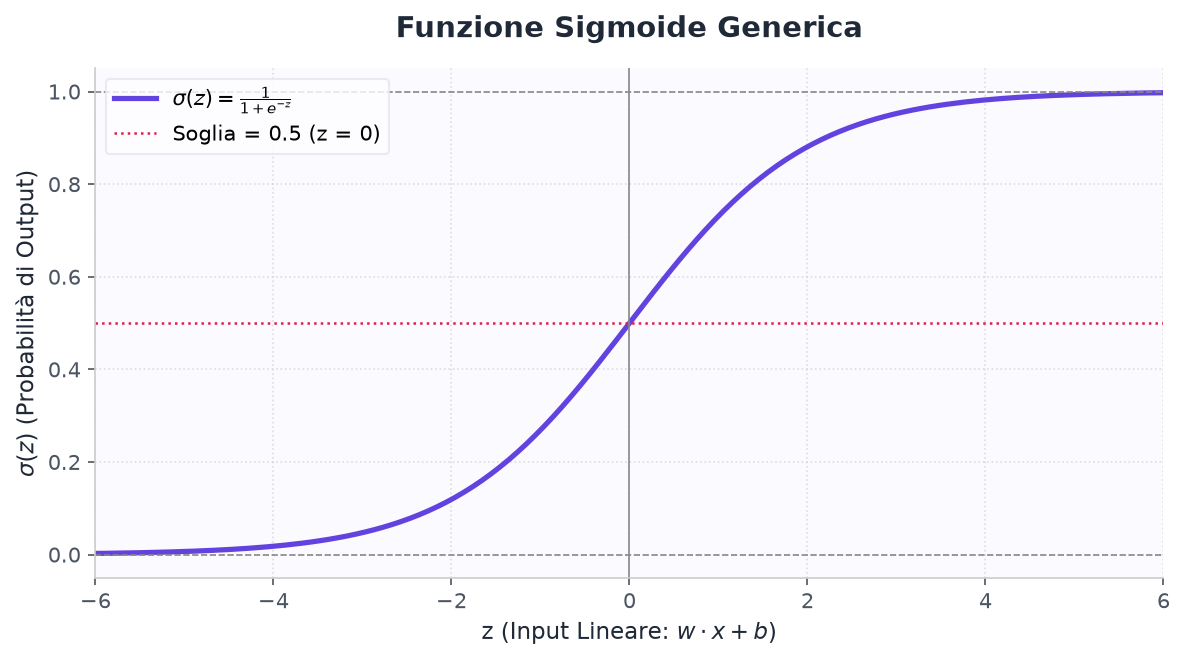
E ne “schiaccia” l’output tra e passandolo attraverso la funzione Sigmoide (o logistica):
Nota Bene (Chiarimento Concettuale): Non si esegue prima una regressione lineare classica per poi passarne il risultato alla sigmoide. Il modello di regressione logistica viene addestrato da zero come un’unica entità. Durante l’addestramento, l’algoritmo ottimizza i pesi e il bias per massimizzare la correttezza della classificazione tramite una funzione di costo chiamata Log Loss (o entropia incrociata), e non tramite la minimizzazione dell’errore lineare (MSE). La combinazione lineare e la sigmoide lavorano insieme fin dall’inizio.
❓ FAQ Didattiche: Capire la Matematica del Modello
-
Perché calcoliamo con una retta () anziché usare un singolo numero costante ? Se usassimo un singolo numero costante , la sigmoide restituirebbe sempre la stessa identica probabilità per chiunque (es. tutti gli studenti avrebbero sempre il di probabilità di promozione). Noi vogliamo invece che la probabilità vari al variare delle caratteristiche dello studente (ore di studio ). La combinazione lineare serve proprio a collegare i dati reali () all’ingresso della sigmoide. Al variare delle ore di studio , varia il valore di e, di conseguenza, la probabilità finale . I parametri (peso) e (bias) definiscono quanto ciascuna caratteristica influisce sul risultato.
-
Che cos’è la Log Loss (Entropia Incrociata)? È la funzione che misura l’errore del modello per correggerlo durante l’addestramento. A differenza dell’errore quadratico (MSE), che misura solo la distanza numerica, la Log Loss penalizza duramente le risposte in cui il modello è sicuro di sé ma sbaglia:
- Se uno studente passa l’esame (classe reale ) e il modello stima una probabilità del (), l’errore (Log Loss) è quasi zero.
- Se lo studente passa (classe reale ) ma il modello stima solo l’ (), la Log Loss applica una penalizzazione logaritmica gigantesca (tende a infinito). Questo errore altissimo costringe l’algoritmo ad aggiustare pesantemente i valori di e per migliorare alla prossima iterazione.
- (Niente panico se la Log Loss ti sembra complessa: approfondiremo la matematica delle funzioni di costo e le loro formule matematiche nell’Unità 3 - Addestramento e Valutazione).
La curva sigmoidea ha una forma a “S” che mappa qualsiasi valore reale di in un valore compreso strettamente tra e :
- Se è molto grande e positivo, , quindi .
- Se è molto grande e negativo, , quindi .
- Se , , quindi .
Soglia Decisionale
Il valore restituito dalla sigmoide rappresenta la probabilità che il campione appartenga alla classe . Per prendere la decisione finale (classe o ), si definisce una soglia decisionale (di solito ):
📊 Un Esempio Pratico di Calcolo (Passo dopo Passo)
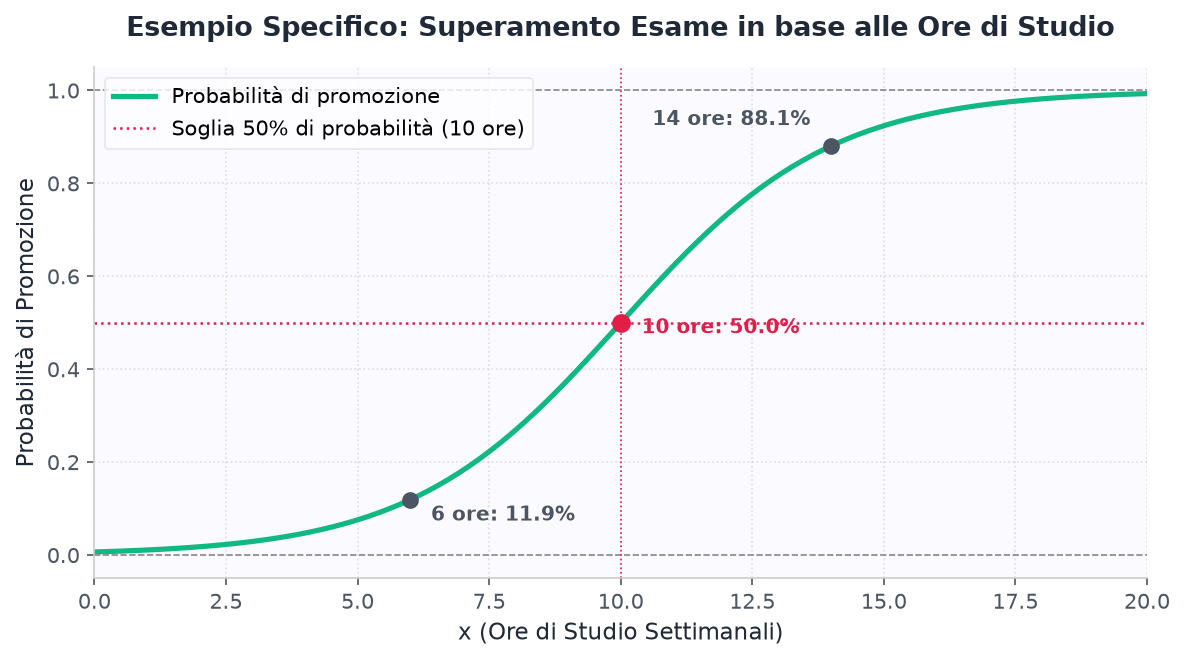
Per rendere tutto semplice e concreto, applichiamo le formule su un esempio reale. Vogliamo prevedere se uno studente supererà l’esame (classe ) o sarà bocciato (classe ) in base alle sue ore di studio settimanali ().
Supponiamo che il nostro modello di regressione logistica sia già stato addestrato e abbia trovato questi parametri:
- Peso (moltiplicatore delle ore):
- Bias (valore di partenza):
La nostra equazione lineare interna è quindi:
Vediamo cosa succede a tre studenti che studiano un numero differente di ore:
1. Studente A ( ore di studio)
- Calcolo di :
- Calcolo della probabilità (Sigmoide):
- Classificazione (Soglia ): Poiché la probabilità del è inferiore alla soglia dello (), il modello prevede che lo studente non supererà l’esame (Classe prevista = 0).
2. Studente B ( ore di studio)
- Calcolo di :
- Calcolo della probabilità (Sigmoide):
- Classificazione (Soglia ): La probabilità è esattamente il . Questo rappresenta il punto di svolta (decision boundary): con meno di 10 ore il modello prevede bocciatura, con 10 o più ore prevede promozione.
3. Studente C ( ore di studio)
- Calcolo di :
- Calcolo della probabilità (Sigmoide):
- Classificazione (Soglia ): Poiché la probabilità del è maggiore della soglia dello (), il modello prevede che lo studente supererà l’esame (Classe prevista = 1).
2.3 Ottimizzazione: La Discesa del Gradiente (Gradient Descent)
L’addestramento di un modello è un processo iterativo di ottimizzazione. Per trovare i parametri e che riducono al minimo l’errore (la funzione di costo, come l’MSE o la Log Loss), si utilizza l’algoritmo di Discesa del Gradiente.
L’analogia della montagna nella nebbia
Immagina di trovarti sulla cima di una montagna nebbiosa e di voler raggiungere la valle (il punto di minimo della funzione di costo, dove l’errore del modello è minimo) senza poter vedere il panorama. L’unica cosa che puoi percepire sotto i tuoi piedi è la pendenza del terreno.
Un’ottima strategia consiste nel fare piccoli passi nella direzione in cui il terreno scende più rapidamente.
Nel Machine Learning facciamo esattamente lo stesso:
- Il Gradiente (, dove sta per Loss function, o funzione di perdita) è un vettore matematico che calcola la pendenza della funzione di errore rispetto a ciascun peso e bias. Indica la direzione di massima salita.
- Per minimizzare l’errore, aggiorniamo tutti i parametri del modello contemporaneamente (nel nostro caso il peso e il bias ) muovendoci nella direzione opposta al gradiente:
Dove:
- rappresenta la Loss function (o funzione di perdita / costo), ovvero la misura dell’errore totale commesso dal modello (come l’MSE o la Log Loss).
- è la derivata parziale della funzione di costo rispetto al peso . Indica come varia l’errore al variare del solo peso .
- è la derivata parziale della funzione di costo rispetto al bias . Indica come varia l’errore al variare del solo bias .
- (la lettera greca eta) è il Tasso di Apprendimento (Learning Rate). Regola la lunghezza del “passo” che facciamo ad ogni aggiornamento.
Il passaggio a modelli complessi
Se invece di una sola caratteristica avessimo un modello con feature, avremmo pesi distinti () e un bias . La discesa del gradiente calcolerebbe derivate parziali distinte (una per ciascun parametro) e le aggiornerebbe tutte insieme a ogni singola iterazione.
La potenza di questo algoritmo risiede proprio nel fatto che funziona allo stesso modo sia per una semplice retta sia per reti neurali profonde con miliardi di parametri.
Vantaggi e svantaggi del calcolo separato
Calcolare una derivata parziale per ciascun parametro separatamente (mantenendo fermi gli altri durante il calcolo) comporta importanti risvolti pratici:
- Vantaggi:
- Scalabilità: Permette all’algoritmo di gestire qualsiasi numero di variabili senza dover cambiare la struttura matematica di base.
- Parallelizzazione: Poiché i calcoli delle derivate parziali dei diversi pesi sono indipendenti, possono essere eseguiti contemporaneamente sfruttando l’architettura delle schede video (GPU).
- Modulazione mirata: Ogni parametro si aggiorna in modo proporzionale al suo specifico impatto sull’errore (un parametro già vicino al valore ottimale avrà una derivata vicina a zero e non subirà variazioni superflue).
- Svantaggi:
- Mancanza di coordinamento locale: Ogni derivata parziale viene calcolata ipotizzando che tutti gli altri parametri siano costanti (ceteris paribus). Dal momento che in realtà l’aggiornamento avviene contemporaneamente per tutti, il percorso del modello verso il minimo può risultare caotico o instabile se il Tasso di Apprendimento () non è configurato con attenzione.
- Costo computazionale complessivo: Per modelli complessi (come le reti neurali profonde con miliardi di parametri), calcolare e tenere in memoria miliardi di derivate a ogni singola iterazione richiede una potenza di calcolo enorme.
L’Importanza del Learning Rate ()
Scegliere il corretto valore del tasso di apprendimento è cruciale:
- Troppo piccolo: I passi sono microscopici. Il modello impiegherà moltissimo tempo ad addestrarsi, rischiando di rimanere bloccato lontano dal minimo reale.
- Troppo grande: I passi sono eccessivi. Il modello rischia di “saltare oltre” il minimo globale, oscillando continuamente o addirittura allontanandosi (l’errore cresce ad ogni tentativo).
2.4 Valutazione dei Modelli: Train e Test Set
Quando addestriamo un modello, l’obiettivo finale non è ottenere prestazioni perfette sui dati storici che già possediamo, ma fare in modo che il modello sia in grado di generalizzare, ovvero fare previsioni corrette su dati nuovi e mai visti prima.
Per verificare questa capacità, è obbligatorio suddividere il nostro dataset iniziale in due parti distinte:
- Training Set (Dataset di Addestramento): Di solito rappresenta l’80% dei dati. Viene utilizzato dal modello per regolare i pesi e il bias tramite la discesa del gradiente.
- Test Set (Dataset di Test): Rappresenta il restante 20% dei dati. Viene tenuto nascosto al modello durante l’addestramento e utilizzato solo alla fine per valutare las prestazioni.
Attenzione (La regola d’oro del Machine Learning): Non valutare mai un modello sugli stessi dati usati per addestrarlo! Sarebbe come dare a uno studente lo stesso identico compito d’esame già svolto in classe: lo studente potrebbe prendere 10 semplicemente memorizzando a memoria le risposte, senza aver compreso la materia.
2.5 Generalizzazione: Overfitting e Underfitting
Analizzando gli errori sul Train Set e sul Test Set, possiamo identificare i due problemi principali del Machine Learning:
1. Underfitting (Sotto-addestramento)
L’underfitting si verifica quando il modello non riesce a catturare la struttura e i pattern fondamentali dei dati. Questo fenomeno può manifestarsi per due cause principali:
-
Underfitting Strutturale: Il modello scelto è intrinsecamente troppo semplice rispetto alla complessità reale del fenomeno (ad esempio, tentare di spiegare con una linea retta dei dati che seguono un andamento parabolico o curvilineo). In questo caso, anche con un addestramento prolungato, l’errore rimarrà comunque molto alto.
-
Underfitting da Mancato Addestramento: Il modello ha la complessità adatta, ma non è stato addestrato a sufficienza. Ciò si verifica principalmente in tre casi:
- Numero di iterazioni insufficiente: Il ciclo di addestramento viene interrotto prima che i parametri abbiano avuto il tempo di convergere verso i valori ottimali.
- Tasso di Apprendimento () troppo piccolo: L’algoritmo compie passi microscopici e richiede troppo tempo per scendere lungo la curva dell’errore, non raggiungendo il minimo nel numero di iterazioni impostato.
- Tasso di Apprendimento () troppo grande: L’algoritmo oscilla violentemente o si allontana del tutto dal valore minimo (divergenza), fallendo il raggiungimento della convergenza.
-
Sintomo: L’errore è elevato sia sul Train Set sia sul Test Set.
-
Soluzione:
- Nel caso di underfitting strutturale: utilizzare un algoritmo più complesso o aggiungere nuove caratteristiche (feature) al dataset.
- Nel caso di mancato addestramento: aumentare il numero di iterazioni dell’algoritmo o ottimizzare il valore del Tasso di Apprendimento ().
2. Overfitting (Sovraddestramento)
Il modello è troppo complesso e ha finito per “memorizzare” i dati di addestramento, compreso il rumore casuale e le anomalie, perdendo la capacità di generalizzare.
- Sintomo: L’errore è casi zero sul Train Set, ma è molto alto sul Test Set.
- Soluzione:
- Ridurre la complessità del modello (es. utilizzare meno caratteristiche o parametri).
- Raccogliere una quantità maggiore di dati di addestramento.
- Utilizzare l’Arresto Anticipato (Early Stopping): questa tecnica monitora l’errore sul Test Set a ogni singola iterazione. All’inizio l’errore cala sia sul Train che sul Test. A un certo punto, però, il modello inizia a memorizzare i dettagli specifici del Train (overfitting): l’errore sul Train continua a scendere verso lo zero, ma l’errore sul Test smette di calare e comincia a risalire. L’Arresto Anticipato interrompe l’addestramento esattamente in questa curva di inversione, salvando i parametri che hanno garantito il minimo errore sui dati di test.
Un approccio professionale: Train, Validation e Test Set
Nel corso di questa unità abbiamo descritto la suddivisione dei dati in due sole parti (Train e Test Set) e il monitoraggio dell’errore sul Test Set per l’Early Stopping. Questa è una semplificazione didattica molto utile per chi inizia.
Tuttavia, nei progetti reali di Machine Learning, questo approccio introduce un errore metodologico chiamato Data Leakage (contaminazione dei dati). Se usiamo il Test Set per decidere quando fermare l’addestramento, stiamo indirettamente sfruttando quelle stesse informazioni di test per ottimizzare il modello (nello specifico, per scegliere l’iterazione ideale). Il risultato finale sul test set sarebbe quindi leggermente distorto e troppo ottimistico.
Per questo motivo, i professionisti suddividono i dati di partenza in tre parti distinte:
- Training Set: I dati utilizzati attivamente dall’algoritmo per aggiornare i pesi e il bias tramite la discesa del gradiente.
- Validation Set: I dati utilizzati durante l’addestramento solo per calcolare l’errore a ogni iterazione e decidere quando fermarsi con l’Early Stopping (senza che l’algoritmo li usi per modificare i pesi).
- Test Set: I dati tenuti rigorosamente chiusi “in cassaforte” e usati una sola volta alla fine di tutto il lavoro per misurare le prestazioni reali del modello congelato.
Come scegliere le proporzioni in base al contesto
La percentuale di dati da destinare a ciascuno dei tre set non è fissa, ma dipende fortemente dalla dimensione totale del dataset:
- Dataset piccoli o medi (fino a qualche decina di migliaia di dati): Si utilizzano le proporzioni classiche come 70% Train / 15% Validation / 15% Test (o 80/10/10). In questo scenario, abbiamo bisogno di riservare percentuali significative per garantire che il Validation Set e il Test Set contengano almeno qualche centinaio o migliaio di campioni, rendendo le valutazioni matematicamente stabili e affidabili.
- Dataset enormi (Big Data / Deep Learning - milioni di dati): Le percentuali cambiano radicalmente. Se disponiamo di 1.000.000 di campioni, l’ rappresenta già 10.000 campioni, una quantità ampiamente sufficiente per validare e testare il modello. In questi contesti si usano proporzioni come 98% Train / 1% Validation / 1% Test (o persino 99% / 0.5% / 0.5%), in modo da destinare la massima quantità possibile di dati all’addestramento del modello, riducendo lo “spreco” di dati nei set di verifica.
2.6 Quadro Riassuntivo delle Metriche di Valutazione
A seconda del tipo di problema (regressione o classificazione), utilizziamo metriche matematiche differenti per valutare le prestazioni sul Test Set.
Per Problemi di Regressione (Predizione di valori continui)
- MSE (Mean Squared Error): Media degli errori al quadrato. Molto sensibile agli errori grandi (outlier).
- RMSE (Root Mean Squared Error): Radice quadrata dell’MSE. Ha il vantaggio di essere espressa nella stessa unità di misura dei dati reali (es. voti, euro).
- R² (Coefficiente di Determinazione): Indica la percentuale di varianza dei dati spiegata dal modello (varia da 0 a 1). Più è vicino a 1, migliore è il modello.
Per Problemi di Classificazione (Predizione di classi discrete)
Per calcolare le metriche di classificazione, analizziamo la Matrice di Confusione che incrocia le classi reali con quelle previste dal modello. Per convenzione internazionale, si utilizzano le sigle in inglese:
- TP (True Positive / Vero Positivo): Il modello prevede la classe positiva e la realtà è positiva.
- TN (True Negative / Vero Negativo): Il modello prevede la classe negativa e la realtà è negativa.
- FP (False Positive / Falso Positivo): Il modello prevede la classe positiva, ma la realtà è negativa (falso allarme).
- FN (False Negative / Falso Negativo): Il modello prevede la classe negativa, ma la realtà è positiva (mancata individuazione).
| Previsto 0 (Negativo) | Previsto 1 (Positivo) | |
|---|---|---|
| Reale 0 (Negativo) | Vero Negativo (TN) | Falso Positivo (FP) |
| Reale 1 (Positivo) | Falso Negativo (FN) | Vero Positivo (TP) |
Partendo da questi 4 valori, calcoliamo le tre metriche fondamentali:
- Accuratezza (Accuracy): La percentuale totale di risposte corrette sul totale dei casi.
- Precisione (Precision): Tra tutti i positivi previsti dal modello, quanti sono realmente positivi? (Evita i falsi allarmi / Falsi Positivi).
- Sensibilità (Recall): Tra tutti i positivi reali presenti nei dati, quanti siamo riusciti a trovarne? (Evita le mancate individuazioni / Falsi Negativi).
2.7 Esercizi e Laboratorio Pratico
Per mettere in pratica le conoscenze teoriche acquisite in questa unità sulla regressione, sulla classificazione e sulla valutazione dei modelli, consulta la sezione pratica del manuale:
- Teoria e Calcolo (Carta e Penna):
- Esercitazione in Python (Scikit-Learn):