Unità 4: Reti Neurali - Dal Percettore al Deep Learning
Nelle unità precedenti abbiamo esplorato due grandi famiglie del Machine Learning classico:
- Modelli Lineari e Logistici (Unità 2): cercano di trovare relazioni o separare le classi tramite formule matematiche lineari;
- Alberi di Decisione e Random Forest (Unità 3): scompongono i problemi attraverso una sequenza gerarchica di domande del tipo
SE... ALLORA..., ideali per dati tabulari.
Tuttavia, quando ci troviamo ad affrontare compiti percettivi complessi su dati non strutturati (come il riconoscimento di immagini composte da milioni di pixel, la comprensione del linguaggio naturale o l’analisi di segnali audio), le regole rigide a cascata e le semplici formule lineari non riescono a cogliere la ricchezza delle informazioni.
Per superare queste sfide nasce il paradigma del Deep Learning (Apprendimento Profondo), basato sulle Reti Neurali Artificiali: modelli capaci di estrarre e combinare autonomamente caratteristiche via via più astratte dai dati grezzi.
In questa unità partiremo dal componente fondamentale — il singolo neurone artificiale (o Percettore) —, analizzeremo i suoi limiti geometrici storici (il problema dello XOR) e vedremo come collegare più neuroni in una Rete Neurale Multistrato (MLP) per risolvere problemi complessi mediante l’algoritmo di Retropropagazione dell’errore (Backpropagation).
4.1 L’Ispirazione Biologica e il Neurone Artificiale
Le reti neurali artificiali traggono ispirazione dalla struttura microscopica del cervello umano, composto da miliardi di neuroni interconnessi attraverso centinaia di trilioni di sinapsi.
L’Analogia Biologica e la Struttura Computazionale
┌──────────────────────────────────────────────────────┐ │ 1. DENDRITI (Ingressi Numerici e Pesi Sinaptici) │ │ • Riceve le feature del campione: x1, x2, ..., xn│ │ • Ciascun canale ha un'importanza: w1, w2, ..., wn│ └──────────────────────────┬───────────────────────────┘ │ ▼ ┌──────────────────────────────────────────────────────┐ │ 2. CORPO CELLULARE (Combinazione Lineare e Bias) │ │ • Esegue la somma pesata di tutti i segnali │ │ • Aggiunge il Bias (b) come soglia di base │ │ │ │ Formula: z = (w1*x1 + w2*x2 + ... + wn*xn) + b │ └──────────────────────────┬───────────────────────────┘ │ ▼ ┌──────────────────────────────────────────────────────┐ │ 3. ASSONE / SINAPSI (Funzione di Attivazione) │ │ • Decide se e quanto il neurone deve "sparare" │ │ • Introduce la non-linearità indispensabile │ │ │ │ Formula: a = f(z) │ └──────────────────────────┬───────────────────────────┘ │ ▼ Output Finale (a)- Nel neurone biologico: I dendriti ricevono segnali elettrochimici da altri neuroni; il corpo cellulare (soma) accumula tali cariche elettriche; se l’accumulo supera una determinata soglia di potenziale, il neurone “spara” un impulso lungo l’ assone, trasmettendolo tramite le sinapsi ai neuroni successivi.
- Nel neurone artificiale: I dendriti sono modellati come ingressi numerici (); ciascuna connessione ha un’importanza quantificata da un peso sinaptico (); il corpo cellulare calcola la somma pesata dei segnali più una costante di bias (); infine, una funzione di attivazione determina l’output numerico finale ().
La Matematica del Percettore (Rosenblatt, 1958)
Il modello matematico del singolo neurone artificiale riceve un vettore di input e produce una risposta attraverso due passaggi sequenziali:
x1 ──( w1 )──┐ │ x2 ──( w2 )──┼──> [ Somma pesata: z ] ──> [ Attivazione: a = f(z) ] ──> Output a │ ▲ xn ──( wn )──┘ │ ( + Bias b )1. Combinazione Lineare (Somma Pesata )
Tutti gli ingressi vengono moltiplicati per i rispettivi pesi e sommati al termine di bias:
- Pesi (): Regolano l’importanza e l’effetto di ogni singola feature sulla decisione del neurone:
- Peso positivo (): Un aumento dell’input incentiva l’attivazione del neurone (effetto eccitatorio);
- Peso negativo (): Un aumento dell’input ostacola l’attivazione (effetto inibitorio);
- Peso nullo o vicino a zero (): La feature viene ignorata (o ha un impatto irrilevante), poiché il prodotto tende a zero e non incide sulla somma.
- Bias (): Rappresenta una soglia intrinseca che consente di traslare la funzione decisionale indipendentemente dal valore degli input (se tutti gli ingressi fossero pari a zero, il neurone avrebbe comunque un valore base ).
2. Applicazione della Funzione di Attivazione ()
Il valore continuo viene passato a una funzione di attivazione per stabilire l’output finale:
Nel Percettore originale di Frank Rosenblatt (1958), la funzione di attivazione era una funzione a gradino (Heaviside Step Function):
Come Imparava il Percettore di Rosenblatt?
L’algoritmo di apprendimento del percettore originale aggiorna i pesi ogni volta che il modello commette un errore di classificazione. Se l’etichetta reale è e la predizione è , la regola di aggiornamento è:
Dove (eta) è il tasso di apprendimento (Learning Rate), un parametro compreso solitamente tra e che controlla l’entità di ciascuna correzione.
- Se la previsione è corretta (), l’errore , quindi nessun peso viene modificato.
- Se il modello ha previsto ma il target era , i pesi associati agli ingressi attivi vengono incrementati.
- Se il modello ha previsto ma il target era , i pesi vengono decrementati.
4.2 Il Limite del Singolo Neurone e il Problema dello XOR
Per comprendere il limite del percettore, dobbiamo chiarire un concetto fondamentale del Machine Learning: il Confine di Decisione (Decision Boundary).
Cos’è il Confine di Decisione?
Quando un modello di classificazione deve decidere se un nuovo dato appartiene alla classe0o alla classe1(es. Spam vs Non Spam, oppure Promosso vs Bocciato), esso traccia una linea di demarcazione nello spazio dei dati. Tutti i punti che cadono da un lato della linea vengono classificati come1, mentre quelli dall’altro lato come0.
Nel singolo percettore, il confine di decisione corrisponde al punto in cui la somma pesata vale esattamente zero (). Sul piano cartesiano a due dimensioni, questa equazione rappresenta sempre una linea retta rigida (o un iperpiano piatto in più dimensioni).
Di conseguenza, un singolo neurone può risolvere esclusivamente problemi linearmente separabili (dove le due classi possono essere separate da una retta).
Le Porte Logiche AND e OR (Separabili) vs XOR (Non Separabile)
Il singolo percettore è perfettamente in grado di apprendere funzioni logiche elementari come l’AND o l’OR, mentre fallisce sistematicamente con la porta XOR (OR Esclusivo):
| Target AND | Target OR | Target XOR | ||
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 1 |
| 1 | 1 | 1 | 1 | 0 |
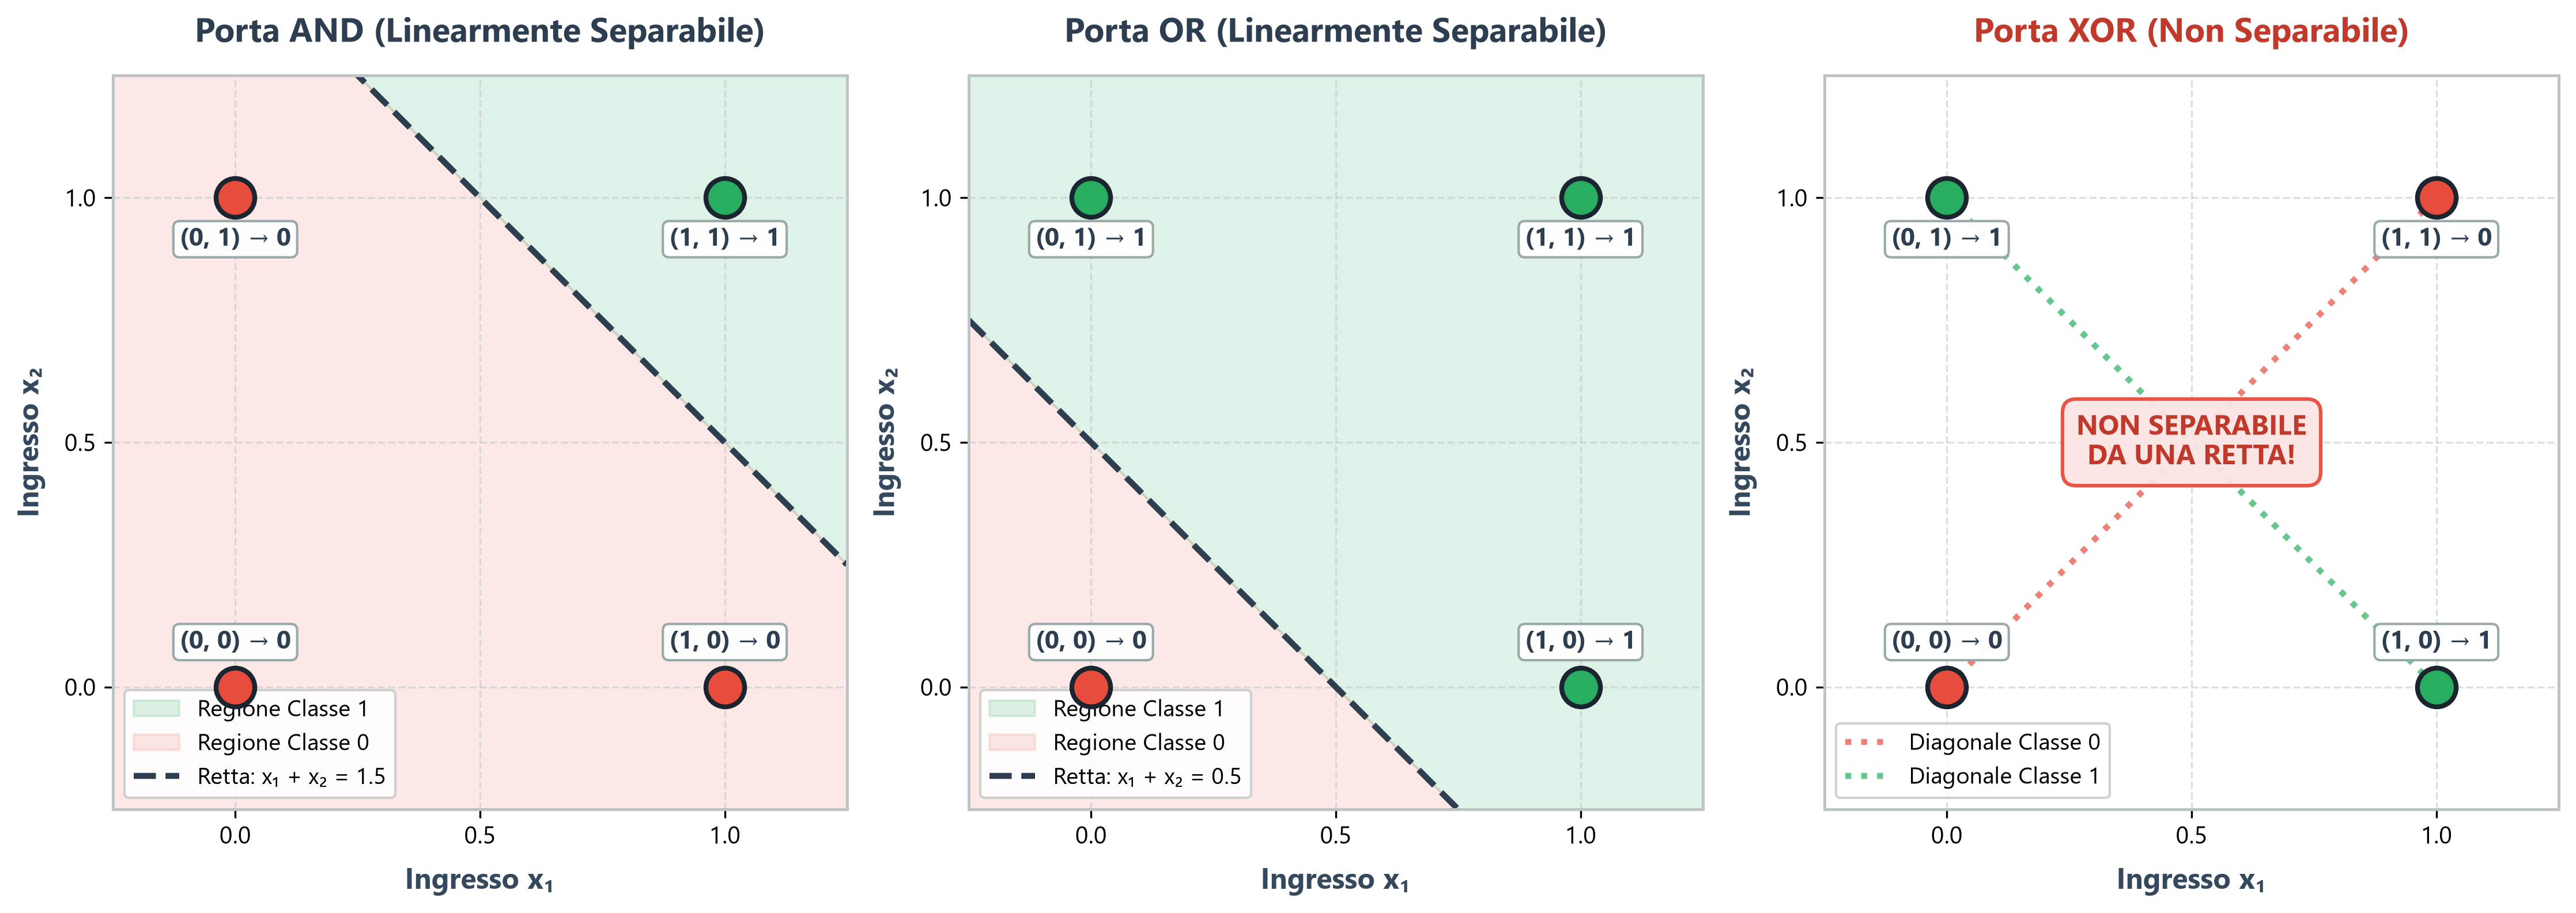
(Clicca sull'immagine per ingrandirla a schermo intero)
Confronto della separabilità lineare sul piano cartesiano per le porte logiche AND, OR e XOR
- Porta AND (a sinistra): I tre punti di classe 0 e l’unico punto di classe 1 sono separati nettamente dalla retta .
- Porta OR (al centro): L’unico punto di classe 0 è isolato dai tre punti di classe 1 dalla retta .
- Porta XOR (a destra): I punti di classe 1 (in verde) e di classe 0 (in rosso) si trovano posizionati su diagonali incrociate ad “X”. È geometricamente impossibile tracciare un’unica retta che separi le due classi: qualunque retta sul piano lascerà sempre almeno un punto nel semipiano errato. Per separare lo XOR servirebbero due rette distinte (ovvero più neuroni combinati tra loro).
La Crisi Storica dell’AI (Minsky & Papert, 1969)
Nel 1969, Marvin Minsky e Seymour Papert pubblicarono il celebre libro Perceptrons, dimostrando matematicamente l’incapacità di un singolo neurone di risolvere lo XOR. Poiché all’epoca non si conosceva un algoritmo efficiente per addestrare reti composte da più strati di neuroni, la ricerca subì una brusca frenata per oltre un decennio, aprendo la stagione del primo “Inverno dell’Intelligenza Artificiale” (AI Winter).
4.3 Le Funzioni di Attivazione e la Non-Linearità
Per superare il limite dello XOR e affrontare problemi complessi, la soluzione è combinare più neuroni in strati successivi. Tuttavia, per rendere efficace questa combinazione, i neuroni devono utilizzare funzioni di attivazione non lineari.
Perché la non-linearità è indispensabile?
Se usassimo solo combinazioni lineari (), una rete neurale anche con decine di strati intermedi si ridurrebbe matematicamente a un unico modello lineare equivalente.
Infatti, la composizione di due funzioni lineari e produce:
La funzione risultante ha sempre la struttura lineare . Senza non-linearità, aggiungere strati non aumenta la capacità del modello di apprendere forme e geometrie complesse.
Le Principali Funzioni di Attivazione
1. Sigmoide (Logistica)
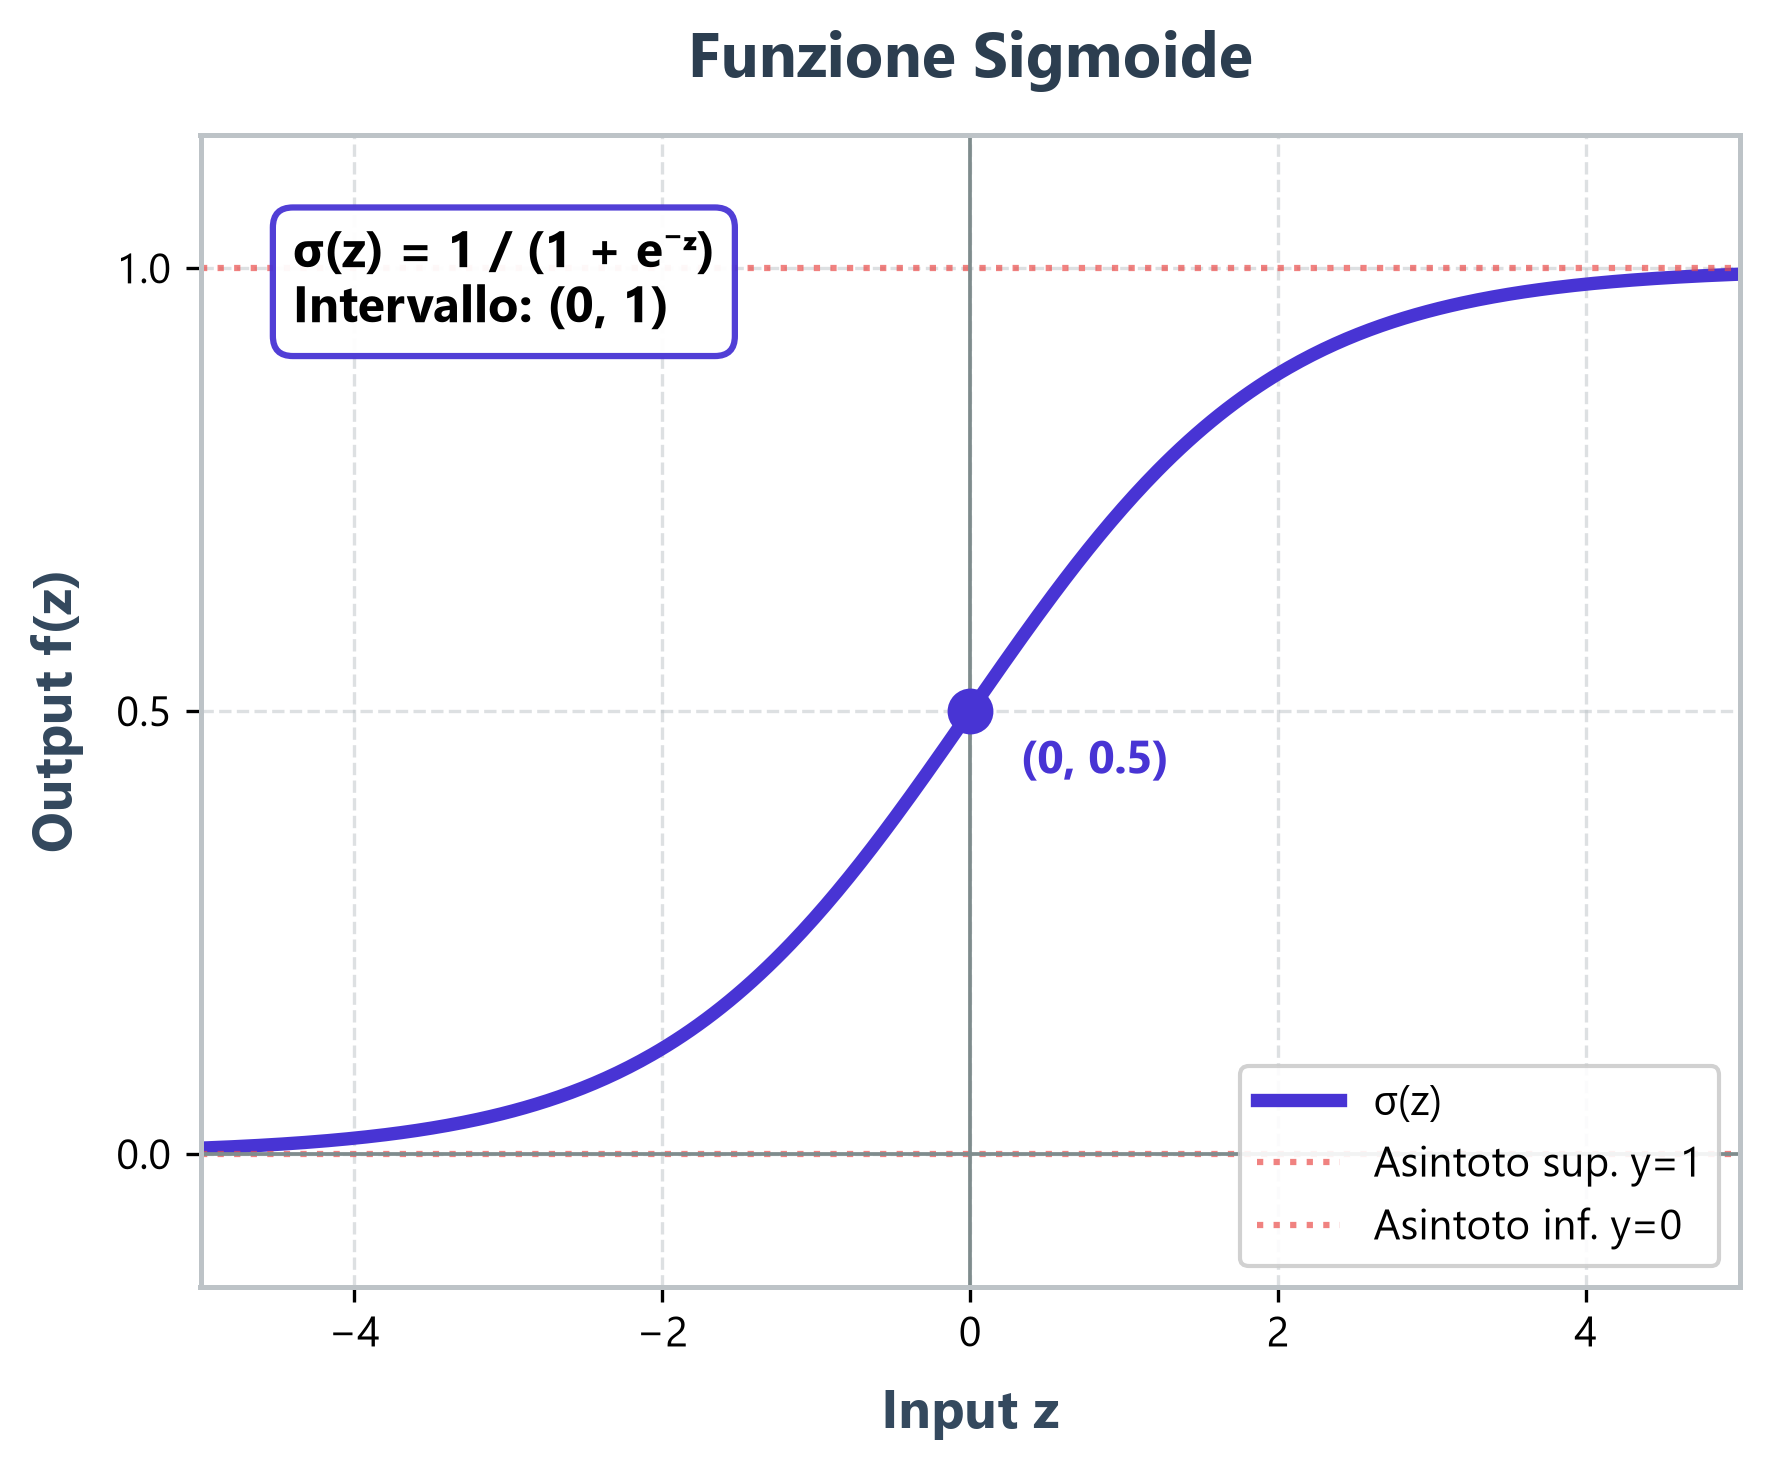
Funzione Sigmoide: $\sigma(z) = \frac{1}{1 + e^{-z}}$
Andamento della funzione di attivazione Sigmoide con asintoti a 0 e 1
- Intervallo: .
- Uso: Converte qualsiasi valore reale in una probabilità compresa tra 0 e 1. È la scelta ideale nello strato di output per problemi di classificazione binaria.
- Limite negli strati nascosti: Per valori di molto grandi (positivi o negativi), la curva si appiattisce quasi completamente e la sua derivata tende a zero. Ciò provoca il fenomeno della saturazione dei gradienti (Vanishing Gradient), che rallenta o blocca l’aggiornamento dei pesi durante la retropropagazione.
2. ReLU (Rectified Linear Unit)
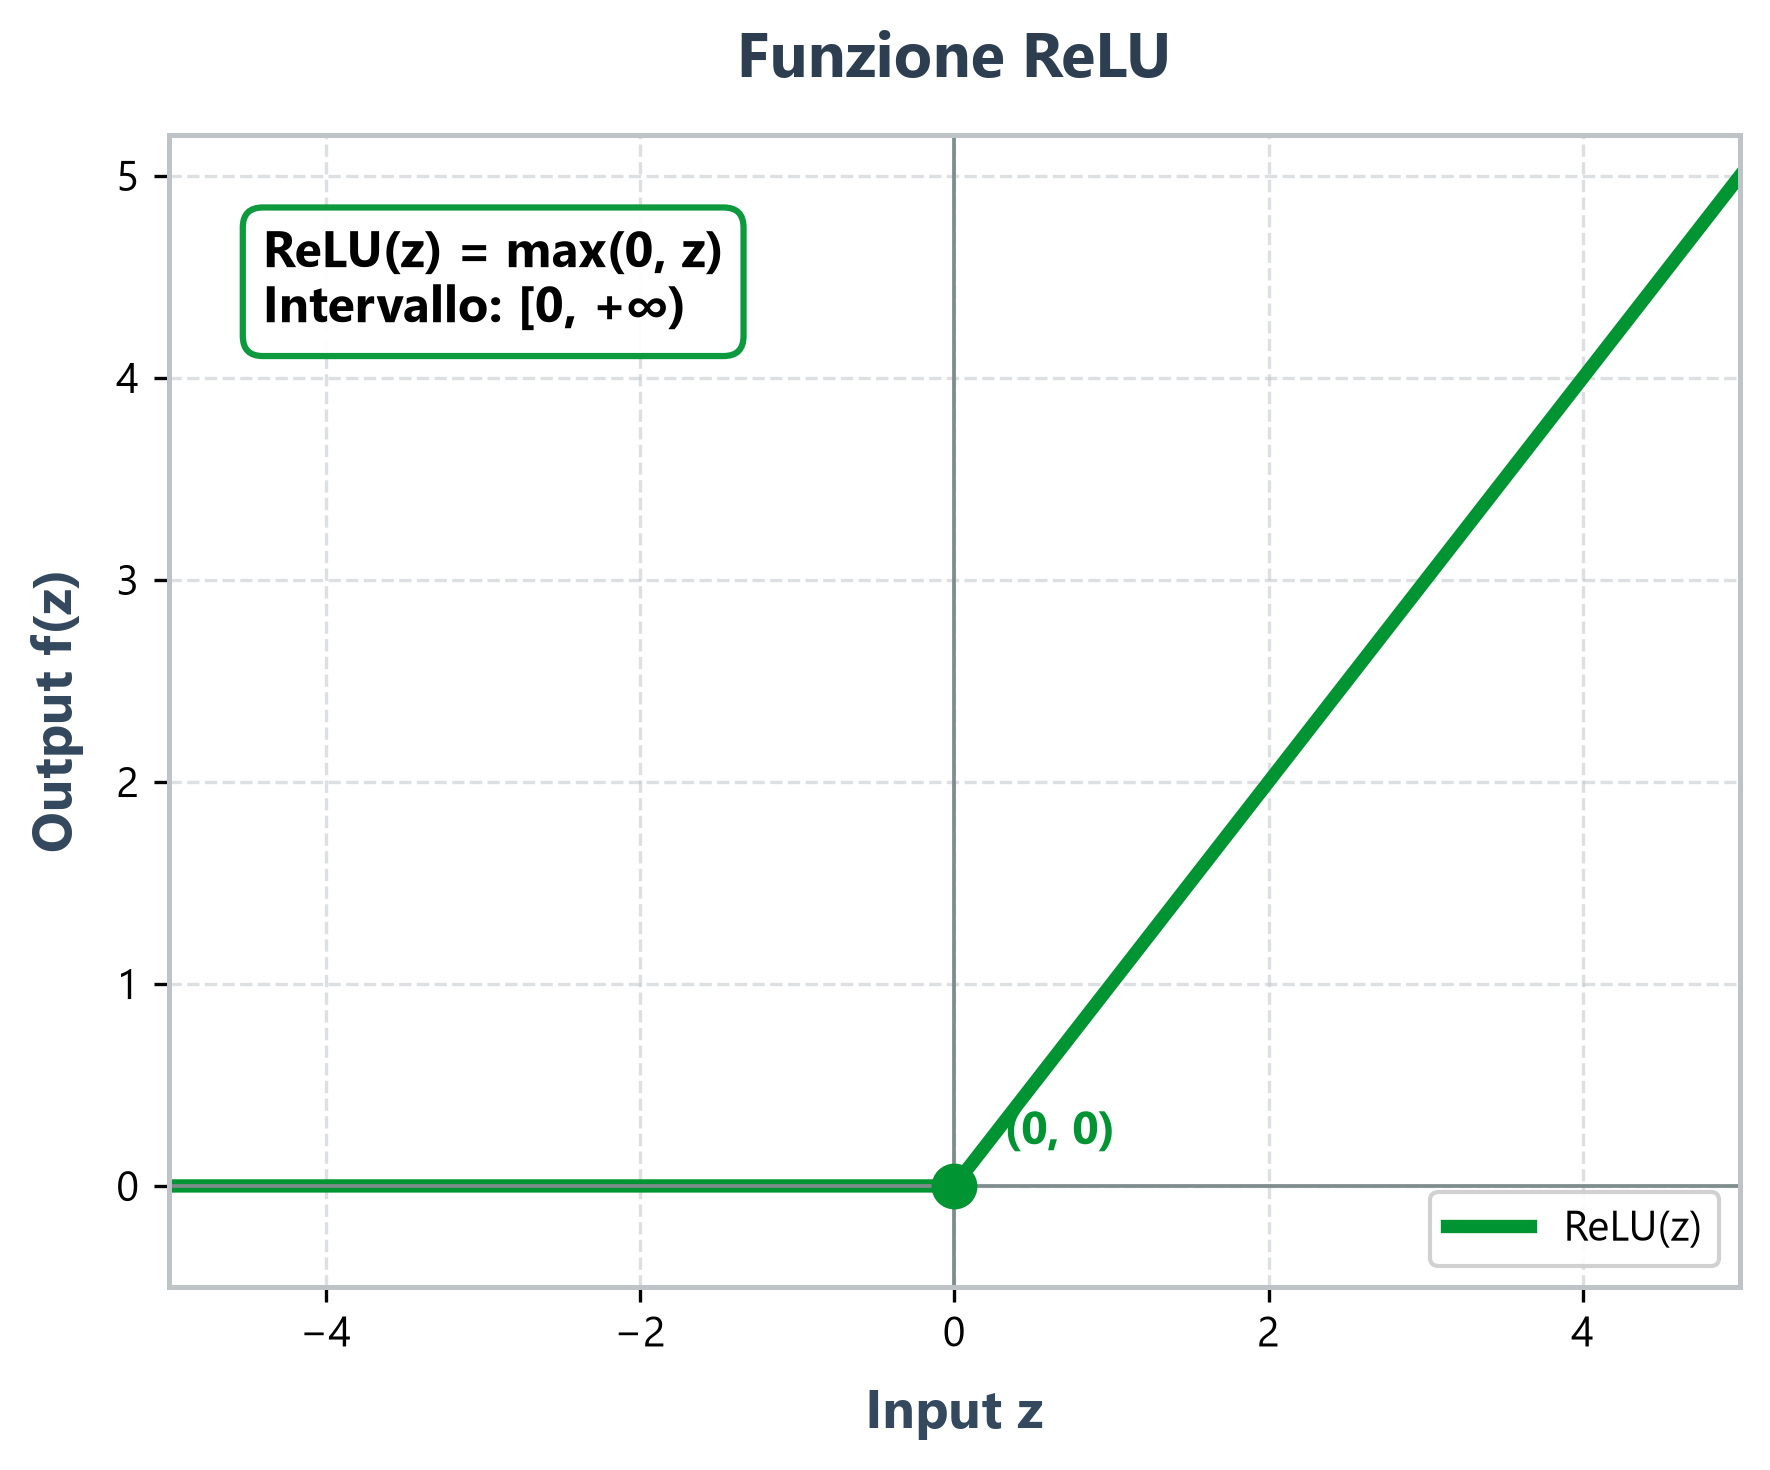
Funzione ReLU: $f(z) = \max(0, z)$
Andamento della funzione di attivazione ReLU (Rectified Linear Unit)
- Intervallo: .
- Uso: È lo standard de facto per gli strati nascosti (hidden layers) nelle reti neurali moderne.
- Vantaggi: È computazionalmente efficientissima (un semplice confronto con lo zero) e per tutti i valori positivi la sua derivata è costante e pari a . Questo evita la saturazione dei gradienti e consente un addestramento molto più rapido e stabile.
3. Tangente Iperbolica ()
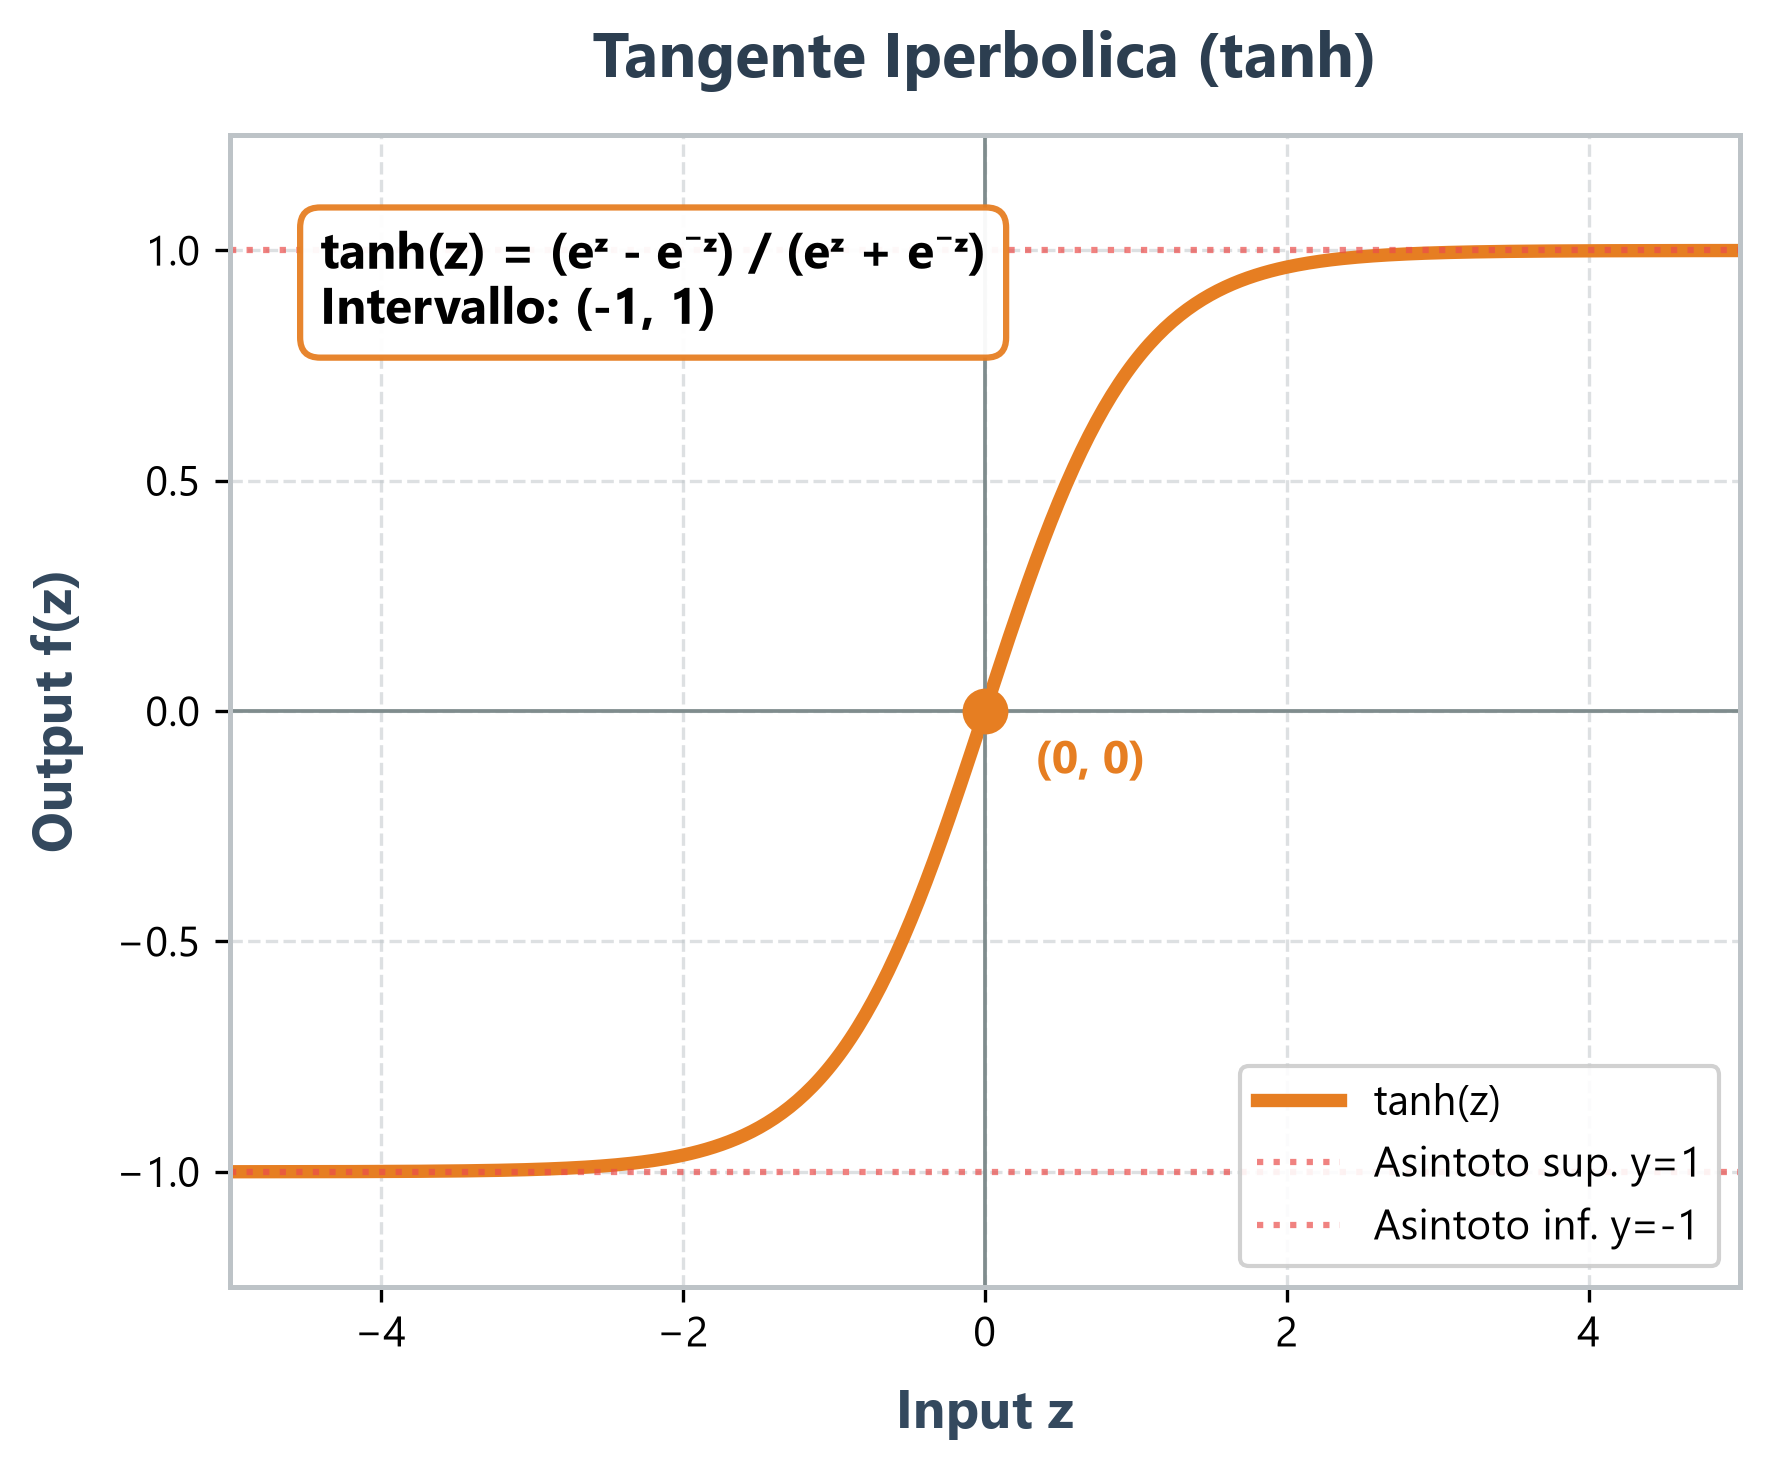
Funzione tanh: $\tanh(z) = \frac{e^z - e^{-z}}{e^z + e^{-z}}$
Andamento della funzione di attivazione Tangente Iperbolica centrata sullo zero
- Intervallo: .
- Uso: Ha una forma simile a quella della sigmoide ma è centrata sullo zero (zero-centered). Questo fa sì che le attivazioni abbiano media vicina a zero, velocizzando la convergenza rispetto alla sigmoide negli strati nascosti.
4. Softmax (per Classificazione Multi-classe)
Nello strato di output per problemi con più di due classi (es. riconoscere le cifre da 0 a 9):
Trasforma i valori in uscita in probabilità la cui somma totale è esattamente ().
4.4 La Rete Neurale Multistrato (MLP)
Collegando i neuroni in strati organizzati si ottiene una Rete Neurale Multistrato (Multi-Layer Perceptron - MLP).
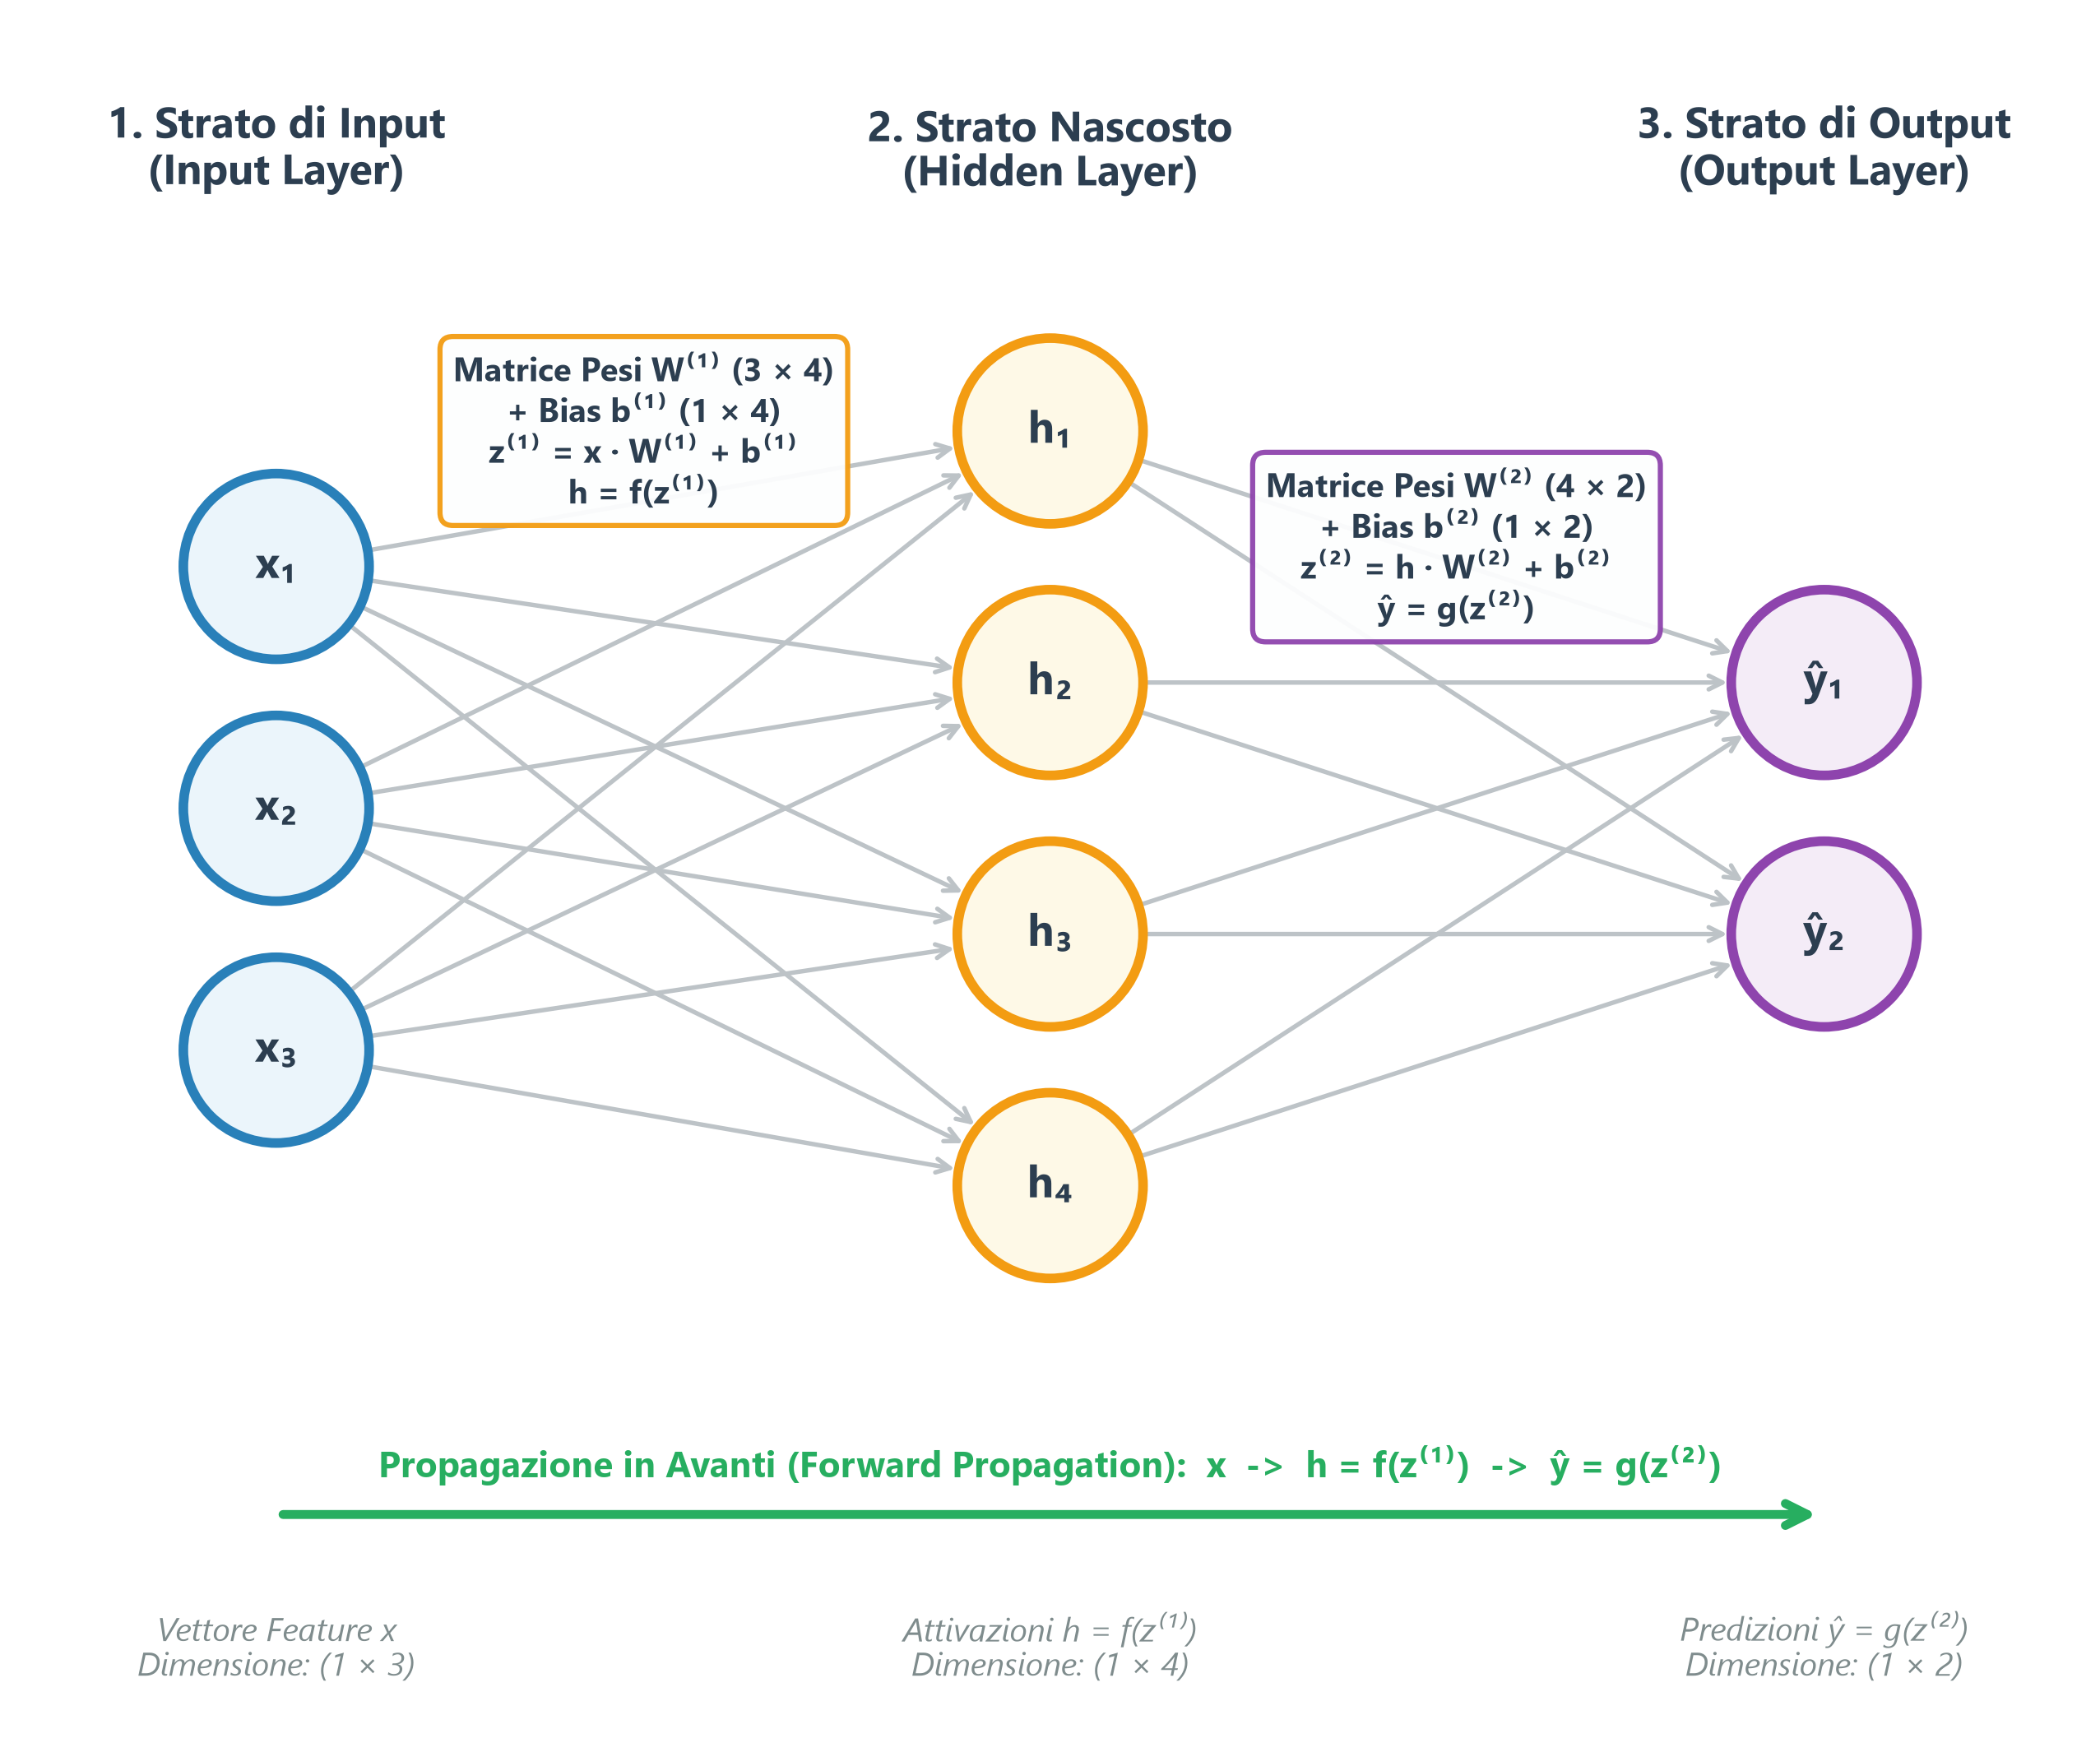
(Clicca sull'immagine per ingrandirla a schermo intero)
Architettura di una Rete Neurale Multistrato (Multi-Layer Perceptron - MLP) con connessioni dense (Fully Connected) e propagazione in avanti
Una rete MLP è composta da tre livelli:
- Strato di Input (Input Layer): Riceve le feature di ciascun campione (es. ore di studio, età, pixel). Non effettua calcoli ma passa semplicemente i numeri in avanti.
- Strati Nascosti (Hidden Layers): Strati intermedi in cui ogni neurone combina i segnali ricevuti e applica un’attivazione non lineare. Questi strati trasformano lo spazio dei dati, “piegandolo” in modo che le classi diventino separabili.
- Strato di Output (Output Layer): Emette la risposta finale (un numero continuo per la regressione o una probabilità per la classificazione).
Dallo Schema alla Matematica: Come Funziona il Calcolo
Osservando lo schema sopra (con 3 feature di input, uno strato nascosto a 4 neuroni e uno strato di output a 2 risposte), vediamo esattamente come i numeri fluiscono attraverso le formule matematiche:
1. Il Calcolo del Singolo Neurone Nascosto ()
Ciascun neurone dello strato nascosto si comporta come il singolo Percettore visto nella sezione 4.1. Ad esempio, il neurone :
- Riceve in ingresso tutte le 3 feature di input moltiplicate per i rispettivi pesi sinaptici: (l’apice indica che siamo nel 1° strato, mentre il pedice indica il peso dal canale di input 1 al neurone 1);
- Applica la funzione di attivazione non lineare (es. ReLU):
Lo stesso calcolo avviene in parallelo per tutti gli altri neuroni .
2. La Forma Compatta Matriciale (Input Nascosto)
Invece di scrivere 4 formule separate, raggruppiamo gli ingressi in un vettore riga , tutti i pesi nella matrice (di dimensione ) e i bias nel vettore :
E le risposte dello strato nascosto diventano il vettore di attivazioni :
3. Dal Livello Nascosto all’Output (Nascosto Output)
Ora le attivazioni calcolate diventano i nuovi ingressi per lo strato di output, che possiede la sua matrice di pesi (di dimensione ) e bias (di dimensione ):
Infine, applicando la funzione di attivazione finale (es. Sigmoide o Softmax), otteniamo le predizioni finali:
4. La Rete come Composizione Unitaria di Funzioni
Unendo i due passaggi, l’intera rete neurale si esprime con un’unica, elegante formula matematica:
- I dati grezzi entrano dal primo strato;
- La funzione interna trasforma lo spazio non lineare delle feature;
- La funzione esterna produce la stima o la classificazione finale .
Perché il Feature Scaling è Fondamentale nelle Reti Neurali?
A differenza degli Alberi di Decisione (che analizzano ogni caratteristica singolarmente con soglie indipendenti e non risentono delle scale numeriche), le Reti Neurali sommano tra loro tutte le feature all’interno della stessa combinazione lineare:
Se è lo stipendio (es. ) e sono gli anni di esperienza (es. ), la feature con i valori più grandi schiaccerà l’altra, rendendo l’addestramento instabile.
Regola pratica: Prima di addestrare una rete neurale, è fondamentale riscalare le feature (ad esempio con
StandardScaleroMinMaxScalerin Scikit-Learn), portando tutte le variabili su una scala numerica comparabile.
4.5 Come Apprende una Rete Neurale: Epoche, Batch e Backpropagation
L’addestramento di una rete neurale consiste nell’aggiustare progressivamente i valori di tutti i pesi e bias affinché le predizioni del modello siano il più vicine possibile alla realtà.
Per capire come avviene questo processo, dobbiamo chiarire come i dati vengono somministrati alla rete e come il computer riesce a calcolare l’errore ed aggiornare i parametri.
Epoche, Batch e Iterazioni
Nel Deep Learning i dataset contengono spesso decine di migliaia (o milioni) di esempi. Per gestire questa mole di informazioni, si utilizzano tre concetti chiave:
- Epoca (Epoch): È un passaggio completo in cui la rete neurale ha elaborato l’intero dataset di addestramento esattamente una volta. Poiché un singolo passaggio non è sufficiente per ottimizzare milioni di parametri, l’addestramento richiede decine o centinaia di epoche.
- Batch (o Mini-batch): È il “blocco” o sottoinsieme di campioni inviato alla rete in un singolo passaggio (ad esempio 32, 64, 100 o 128 immagini alla volta).
- Iterazione (o Step): È il singolo aggiornamento dei pesi che la rete esegue dopo aver elaborato un batch.
Come fa la rete a lavorare su 100 immagini in un colpo solo?
Potrebbe sembrare che la rete debba elaborare le 100 immagini una dopo l’altra con un lento ciclo for. In realtà, il processo sfrutta due principi fondamentali:
1. Il motivo statistico: L’Errore Medio
Invece di correggere i pesi basandosi sull’errore di una singola immagine (che potrebbe essere un’anomalia o contenere rumore), la rete:
- Calcola la predizione e il rispettivo errore per ciascuna delle 100 immagini del blocco;
- Calcola la media aritmetica dell’errore su tutto il batch:
- Esegue un unico aggiornamento dei pesi, muovendosi nella direzione media indicata dal gruppo. In questo modo le oscillazioni casuali si annullano e l’apprendimento procede in modo molto più fluido e stabile.
2. Il motivo computazionale: Algebra Matriciale e GPU
Come fa il processore a calcolare 100 immagini contemporaneamente?
- Invece di passare un singolo vettore di feature alla volta (), il computer impila le 100 immagini una sotto l’altra formando una Matrice dei Dati con 100 righe e colonne.
- Le schede video moderne (GPU), nate per la grafica 3D, contengono migliaia di piccoli core specializzati nell’eseguire moltiplicazioni tra matrici in parallelo.
- Con una singola operazione matriciale: la GPU calcola le attivazioni di tutte le 100 immagini nello stesso identico ciclo di clock, in poche frazioni di millisecondo!
Le 4 Fasi del Ciclo di Addestramento
Ad ogni iterazione (su ciascun batch di dati), la rete ripete un ciclo composto da quattro fasi consecutive:
┌────────────────────────────────────────────────────────┐ │ 1. FORWARD PROPAGATION (Propagazione in Avanti) │ │ • Il batch di dati attraversa la rete (Input ──> Out│ │ • Calcolo di z e attivazione a per ciascun layer │ │ │ │ Formule: Z = X*W + b ──> A = f(Z) ──> Y_pred │ └───────────────────────────┬────────────────────────────┘ │ ▼ ┌────────────────────────────────────────────────────────┐ │ 2. CALCOLO DELLA LOSS (Misura dell'Errore Medio) │ │ • Confronta le predizioni Y_pred con i target reali │ │ │ │ Regressione (MSE): L = 1/B * Σ (y - y_pred)^2 │ │ Classificazione (Loss): L = - 1/B * Σ [y*log(y_pred)│ └───────────────────────────┬────────────────────────────┘ │ ▼ ┌────────────────────────────────────────────────────────┐ │ 3. BACKPROPAGATION (Retropropagazione dell'Errore) │ │ • L'errore viaggia all'indietro strato per strato │ │ • Calcolo dei gradienti tramite la Regola Catena │ │ │ │ Gradiente: dL/dW = (dL/dy_pred) * (dy_pred/dz) *...│ └───────────────────────────┬────────────────────────────┘ │ ▼ ┌────────────────────────────────────────────────────────┐ │ 4. DISCESA DEL GRADIENTE (Aggiornamento Parametri) │ │ • I pesi vengono corretti per ridurre la Loss │ │ • Passo di correzione regolato dal Learning Rate η │ │ │ │ Formula: W_nuovo = W_vecchio - η * (dL/dW) │ └────────────────────────────────────────────────────────┘-
Forward Propagation (Propagazione in Avanti):
- Cosa fa: Il batch di dati attraversa la rete dall’input all’output. In ogni strato si calcola la combinazione lineare e si applica l’attivazione non lineare , fino a ottenere le predizioni finali .
- Intuizione: È la rete che “fa la sua previsione” sulla base dei pesi che possiede in quel momento.
-
Calcolo della Loss (Misura dell’Errore):
- Cosa fa: Confronta le previsioni della rete () con i valori reali corretti () per quantificare l’errore medio commesso sul batch:
- Per la Regressione (Mean Squared Error - MSE):
- Per la Classificazione (Binary Cross-Entropy):
- Intuizione: È il “voto del compito”: un unico numero che misura quanto la rete è lontana dal risultato corretto.
- Cosa fa: Confronta le previsioni della rete () con i valori reali corretti () per quantificare l’errore medio commesso sul batch:
-
Backpropagation (Retropropagazione dell’Errore):
- Cosa fa: È l’algoritmo (Rumelhart et al., 1986) che calcola il gradiente per ciascun parametro, ossia la derivata dell’errore rispetto al singolo peso (o all’intera matrice ). Per risalire dall’output fino ai primi strati nascosti, applica a ritroso la Regola della Catena (Chain Rule):
- Intuizione (La “distribuzione delle responsabilità”): Immagina una catena di montaggio in cui il prodotto finale esce difettoso. Il controllo qualità risale la fabbrica all’indietro per capire chi e quanto ha contribuito all’errore. La derivata risponde semplicemente a una domanda pratica: “Se aumento questo specifico peso di un briciolo (), l’errore finale salirà o scenderà, e con quale velocità?”.
-
Aggiornamento dei Parametri (Discesa del Gradiente):
- Cosa fa: Conoscendo la direzione dell’errore, corregge i parametri muovendoli in senso opposto alla pendenza:
- Per il singolo peso e il singolo bias :
- In forma matriciale compatta (tutti i milioni di pesi aggiornati contemporaneamente dalla GPU):
- Intuizione (La discesa nella nebbia): Immagina di essere in montagna avvolto da una fitta nebbia e di voler raggiungere la valle (il minimo dell’errore). Non vedi la mappa completa, ma con i piedi senti la pendenza del terreno sotto di te e fai un passo verso il basso:
- Se il passo è troppo grande, rischi di scavalcare la valle e finire sul versante opposto;
- Se il passo è troppo piccolo, impiegherai un tempo infinito a scendere;
- Gli ottimizzatori moderni (come Adam) funzionano come “scarponi intelligenti” che allungano o accorciano il passo automaticamente a seconda della ripidità del terreno.
- Cosa fa: Conoscendo la direzione dell’errore, corregge i parametri muovendoli in senso opposto alla pendenza:
4.6 Sintesi del Modulo: Come i Modelli Tracciano i Confini
Ora che conosciamo i tre grandi paradigmi del Machine Learning (Modelli Lineari, Alberi e Reti Neurali), possiamo confrontarli osservando il modo in cui ciascuno divide lo spazio delle decisioni:
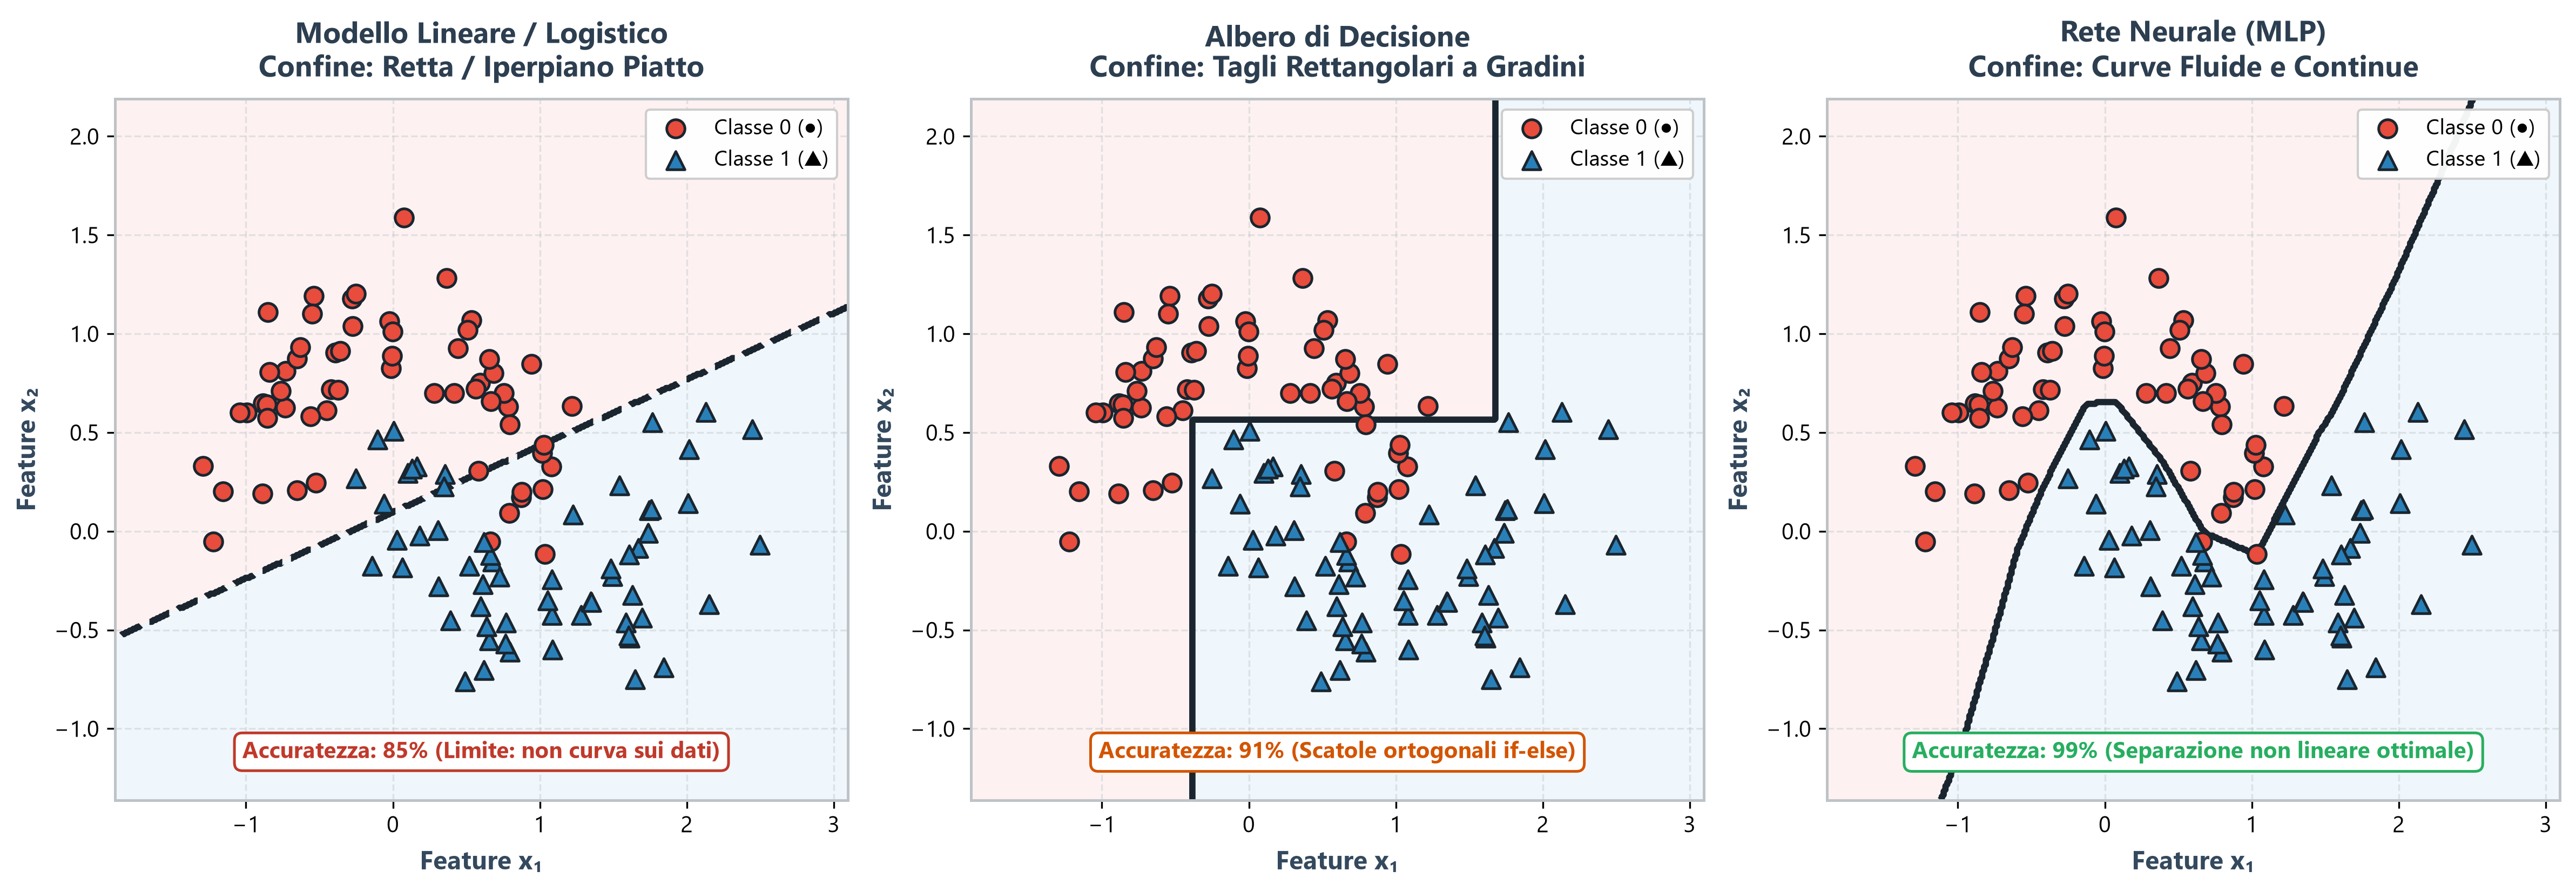
(Clicca sull'immagine per ingrandirla a schermo intero)
Confronto geometrico della forma del confine di decisione: Modelli Lineari (retta/iperpiano), Alberi di Decisione (tagli ortogonali a scatola) e Reti Neurali MLP (superfici curvilinee flessibili)
Tabella Comparativa dei Paradigmi
| Aspetto | Modelli Lineari / Logistici | Alberi di Decisione / Random Forest | Reti Neurali (Deep Learning) |
|---|---|---|---|
| Confine di Decisione | Retta o Iperpiano piatto (separa con un piano geometrico continuo) | A gradini / scatole (combinazione di tagli ortogonali agli assi) | Superfici curvilinee arbitrarie (forme complesse e flessibili) |
| Campi di Utilizzo Ideali | Relazioni semplici, dataset piccoli o lineari | Dati tabulari (fogli Excel, database con feature eterogenee) | Dati non strutturati (immagini, segnali audio, testo, video) |
| Interpretabilità | Alta: i pesi indicano direttamente l’importanza di ciascuna feature | Alta: le regole decisionali possono essere lette e stampate come diagrammi di flusso | Bassa (“scatola nera”): le decisioni derivano da milioni di parametri distribuiti |
| Scalatura dei Dati (Scaling) | Spesso raccomandata per regolarizzazione o discesa del gradiente | Non necessaria: insensibili all’ordine di grandezza delle colonne | Indispensabile: pesi e gradienti dipendono dalla scala numerica dei dati |
4.7 Esercizi e Laboratorio Pratico
Per consolidare la comprensione teorica e sperimentare l’addestramento pratico di un Percettore e di una Rete Neurale Multistrato in Python:
- Verifica Teorica e Calcolo a Mano:
- Esercitazione Pratica in Python: